Recuperação de desastres
A recuperação de desastres (DR) mantém uma cópia de reserva de uma instalação em um segundo servidor, de preferência em outro prédio ou data center. Se o local que executa a instalação for perdido, um administrador pode fazer failover: a reserva passa a ser a instalação que as pessoas usam.
A recuperação é assíncrona. A reserva está sempre um pouco atrasada, então as gravações mais recentes podem se perder em um failover.
Como funciona
Seção intitulada “Como funciona”Quando você ativa a DR para uma instalação, a plataforma:
- Cria uma instalação de reserva no servidor que você escolher, com o nome da original acrescido de (RD), por exemplo Programme analytics (RD), com o status Em reserva. Só os bancos de dados da reserva ficam em execução. O aplicativo em si fica parado e não atende ninguém: a reserva não tem rota, então o endereço web dela responde HTTP 404 até ser promovida.
- A cada 15 minutos, pede ao agente do servidor original que faça um backup de cada banco de dados que o aplicativo declara e o envie para seu armazenamento de artefatos, um bucket compatível com S3. Cada envio é um ponto de recuperação. Os backups são criptografados com uma senha de repositório escolhida por você. No nível Contínuo, os bancos de dados PostgreSQL e MariaDB também enviam suas alterações a cada dois minutos, aproximadamente.
- Pede ao agente do servidor de recuperação que restaure cada novo ponto de recuperação nos bancos de dados da reserva.
- Uma vez por dia, restaura o ponto de recuperação mais recente em um banco de dados temporário no servidor de recuperação, verifica-o e depois exclui a cópia temporária. Um ponto de recuperação aprovado na verificação é marcado como VERIFIED.
O failover nunca é automático. É sempre um administrador que o inicia.
Objetivo de ponto de recuperação
Seção intitulada “Objetivo de ponto de recuperação”O objetivo de ponto de recuperação (RPO) é a quantidade de dados recentes que você pode perder. A DR tem dois níveis:
| Nível | O que é enviado para o armazenamento de artefatos | Dados que você pode perder |
|---|---|---|
| Intervalo (T1) | Um backup lógico de cada banco de dados a cada 15 minutos | Até 30 minutos |
| Contínuo (T2) | Para bancos de dados PostgreSQL e MariaDB: suas alterações a cada 2 minutos, aproximadamente, além de uma base a cada 6 horas | Normalmente de 1 a 3 minutos |
Todas as instalações começam em Intervalo. Quando o plano da sua organização incluir o nível Contínuo e a verificação diária mostrar os bancos de dados prontos, um Administrador da organização pode mudar para ele na aba Recuperação de desastres. Consulte Nível Contínuo.
Em Contínuo, só os bancos de dados PostgreSQL e MariaDB são enviados continuamente. Os demais bancos de dados do aplicativo, como o MongoDB, e seus arquivos mantêm o backup a cada 15 minutos, então ainda podem perder até 30 minutos. O RPO principal é o mais lento de todos.
Antes de começar
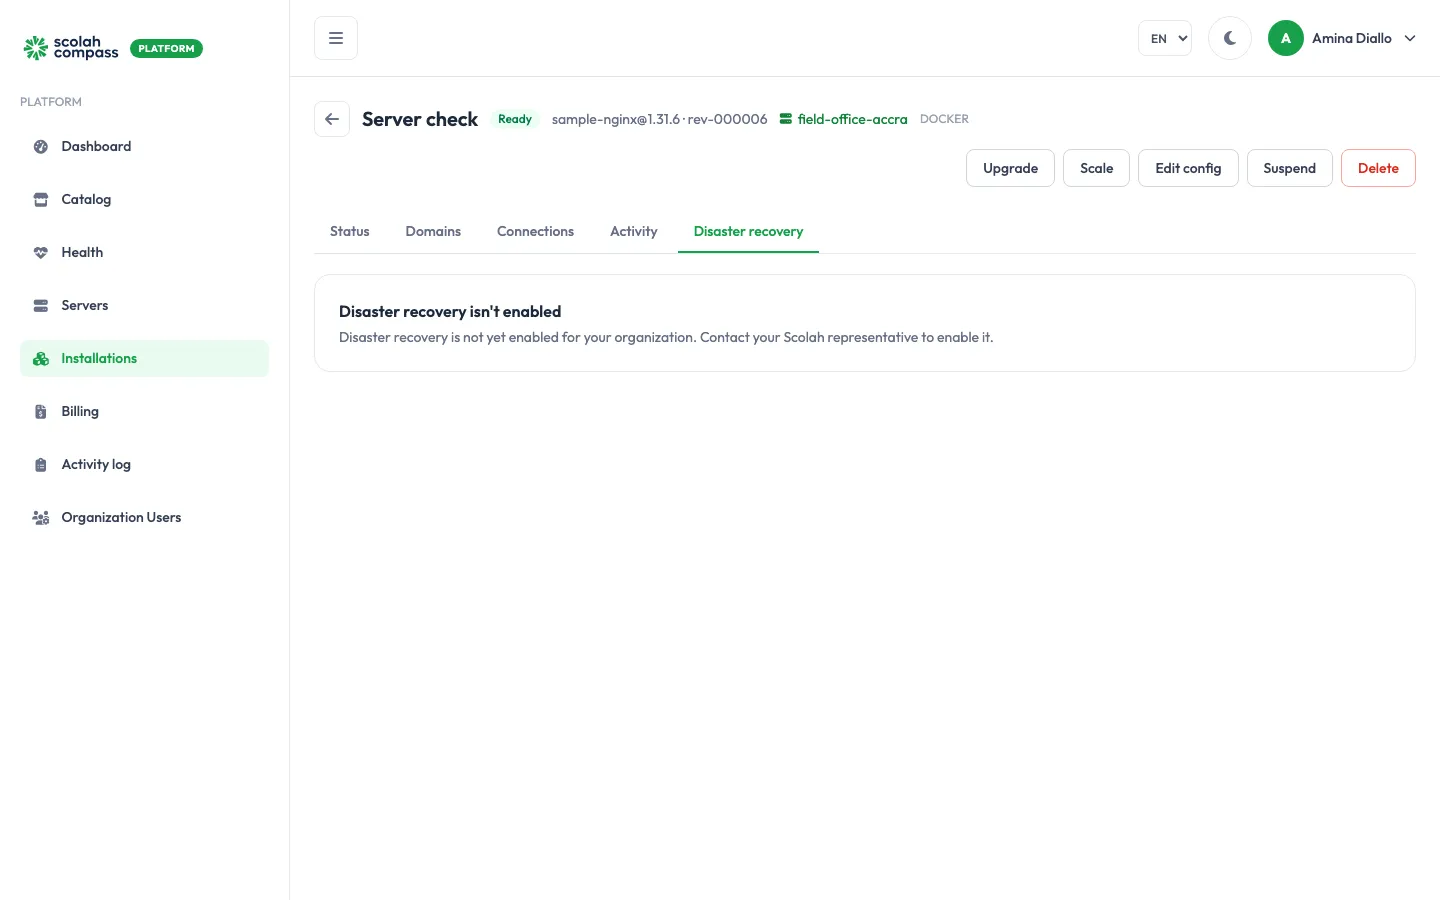
Seção intitulada “Antes de começar”- Sua organização precisa ter a DR ativada. A Scolah a ativa por organização. Até lá, a aba Recuperação de desastres mostra A recuperação de desastres não está ativada. Entre em contato com seu representante Scolah para ativá-la.
- Você precisa ser Administrador da organização para ativar ou desativar a DR, executar um teste, fazer failover, voltar ao primário e usar a promoção de emergência. Os membros podem ver a aba de uma instalação protegida e usar Fazer backup agora.
- Um segundo servidor, um servidor Docker ou um cluster Kubernetes, diferente daquele onde a instalação está rodando, que esteja:
- conectado, com um sinal nos últimos 5 minutos
- marcado como elegível para recuperação
- pelo menos do mesmo tamanho que o servidor original: o mesmo número de núcleos de CPU e 95% da memória dele, para que a reserva possa assumir toda a carga
- com pelo menos 10 GiB de disco livre (50 GiB ou mais evita um aviso)
- Um bucket compatível com S3 que os dois servidores consigam alcançar, e uma chave de acesso para ele. Mantenha-o longe do local original; caso contrário, uma falha do local leva junto seus pontos de recuperação. Sem bucket, o servidor de recuperação não tem a partir de onde restaurar (consulte Armazenamento de artefatos).
- Um domínio na instalação. O failover move os domínios da instalação para o servidor de recuperação. Quem acessa a instalação pelo endereço IP não a acompanha.
A instalação e sua reserva podem rodar, cada uma, em um servidor Docker ou em um cluster Kubernetes. Consulte Clusters Kubernetes.
Quando a aba mostra um aviso
Seção intitulada “Quando a aba mostra um aviso”Se a DR não estiver ativa para a instalação e você não puder ativá-la, a aba Recuperação de desastres explica o motivo em vez de mostrar o assistente:
| Aviso | Motivo |
|---|---|
| A recuperação de desastres não está ativada | A Scolah ainda não ativou a DR para sua organização. |
| A recuperação de desastres é gerenciada pelos administradores da sua organização | Você é membro. Só um Administrador da organização pode ativar a DR; depois de ativada, você pode acompanhar o status dela na aba. |
| A recuperação de desastres está temporariamente indisponível | A Scolah desligou a DR na plataforma por enquanto. As instalações já protegidas continuam protegidas. Tente mais tarde. |
| Não foi possível verificar o status da recuperação de desastres | O portal não conseguiu determinar se a DR está disponível. Recarregue a página. |
Quais aplicativos são protegidos
Seção intitulada “Quais aplicativos são protegidos”O aplicativo precisa descrever seus dados em uma especificação de backup (backup.json). Estes aplicativos do catálogo têm uma:
| Aplicativo | Bancos de dados copiados | Arquivos |
|---|---|---|
| Scolah Compass | PostgreSQL (4 bancos de dados), MongoDB | Arquivos de mídia (MinIO) |
| Scolah Compass Resources | PostgreSQL | Comprovantes (MinIO) |
| DHIS2 | PostgreSQL | Pasta pessoal do DHIS2 |
| ERPNext | MariaDB | Pasta de sites |
| HOPE | PostgreSQL | Pasta de dados |
| Keycloak | PostgreSQL | — |
| KoboToolbox | PostgreSQL (2 bancos de dados), MongoDB | — |
| LiteLLM | PostgreSQL | — |
| Metabase | PostgreSQL | — |
| Moodle | PostgreSQL | Pasta de dados do Moodle |
| OpenEWS | PostgreSQL | — |
| openIMIS | PostgreSQL | Pasta de fotos |
| OpenMRS | MariaDB | Pasta de dados |
Os caches Redis são ignorados, porque o aplicativo os reconstrói. A fila de tarefas Redis do KoboToolbox é copiada e restaurada junto com seus bancos de dados, então as tarefas na fila acompanham a instalação até a reserva. O Sample (nginx) não armazena dados que valha a pena proteger.
Ativar a recuperação de desastres
Seção intitulada “Ativar a recuperação de desastres”- Abra a instalação e clique na aba Recuperação de desastres.
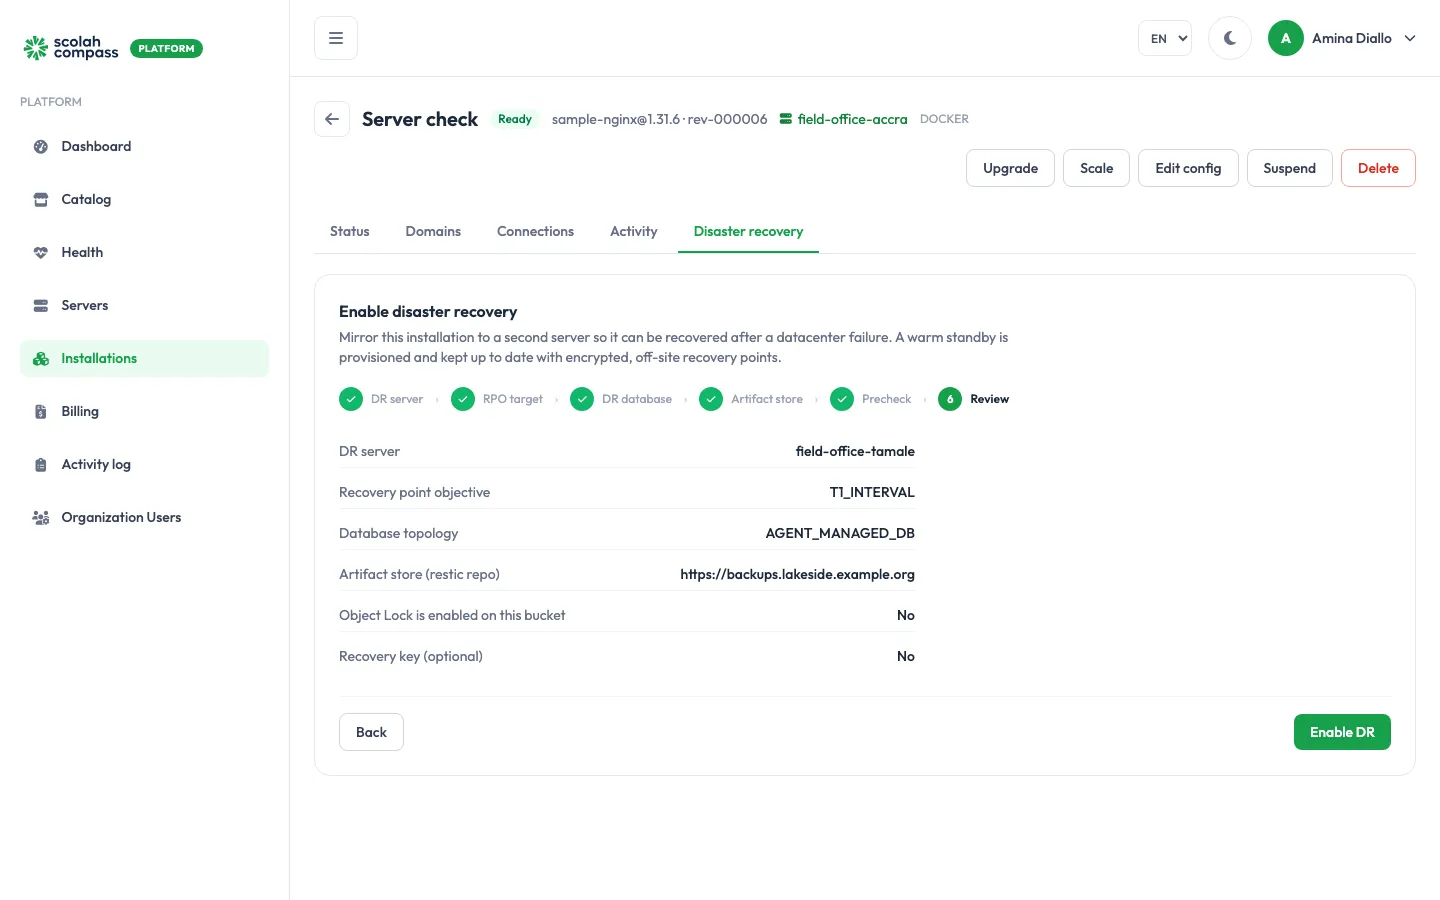
- Siga as seis etapas de Ativar a recuperação de desastres e depois clique em Ativar recuperação.
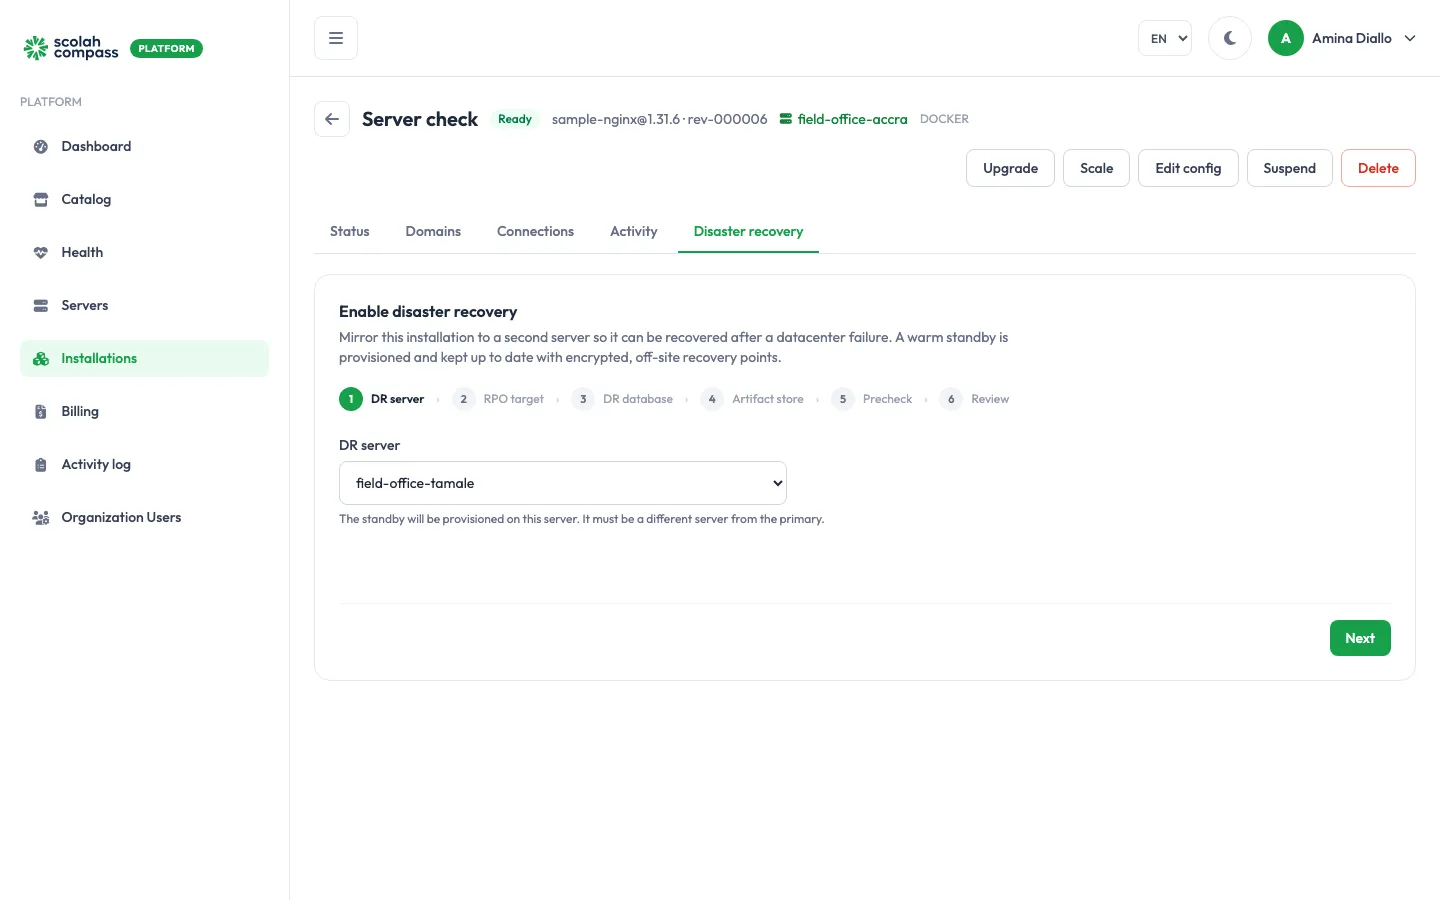
1. Servidor de recuperação
Seção intitulada “1. Servidor de recuperação”Escolha o servidor que vai hospedar a reserva. A lista mostra apenas servidores elegíveis para recuperação que não sejam o da própria instalação. Se ela estiver vazia, você verá Não há servidores elegíveis para recuperação: primeiro marque um servidor como elegível.
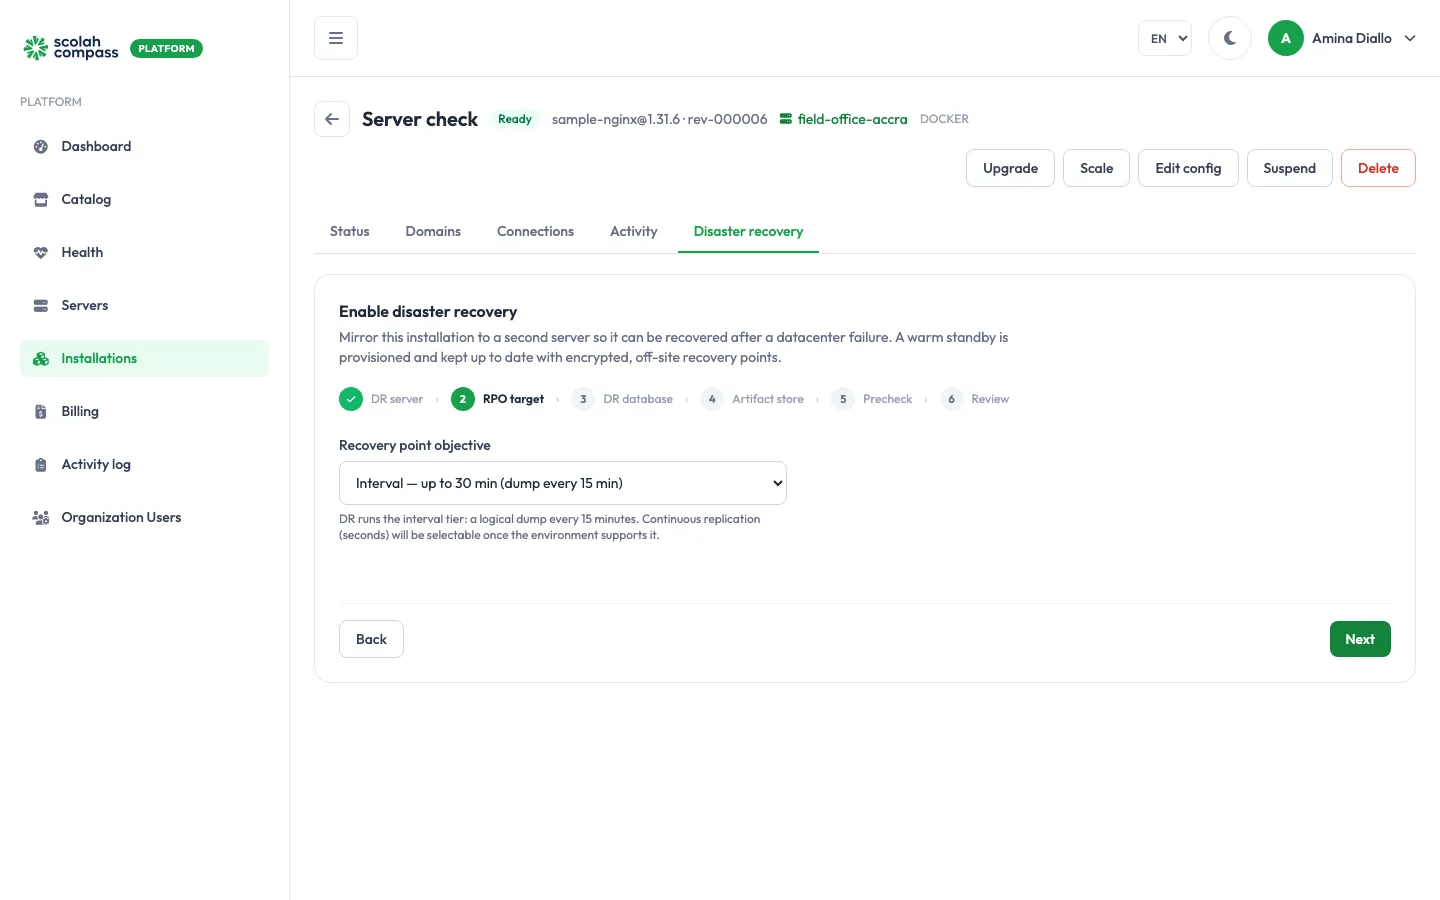
2. Objetivo RPO
Seção intitulada “2. Objetivo RPO”Objetivo de ponto de recuperação oferece uma opção: Intervalo — até 30 min (cópia a cada 15 min). A DR sempre começa em Intervalo. Depois, você pode mudar para Contínuo na aba Recuperação de desastres, assim que estiver disponível (consulte Nível Contínuo).
3. Banco de dados de recuperação
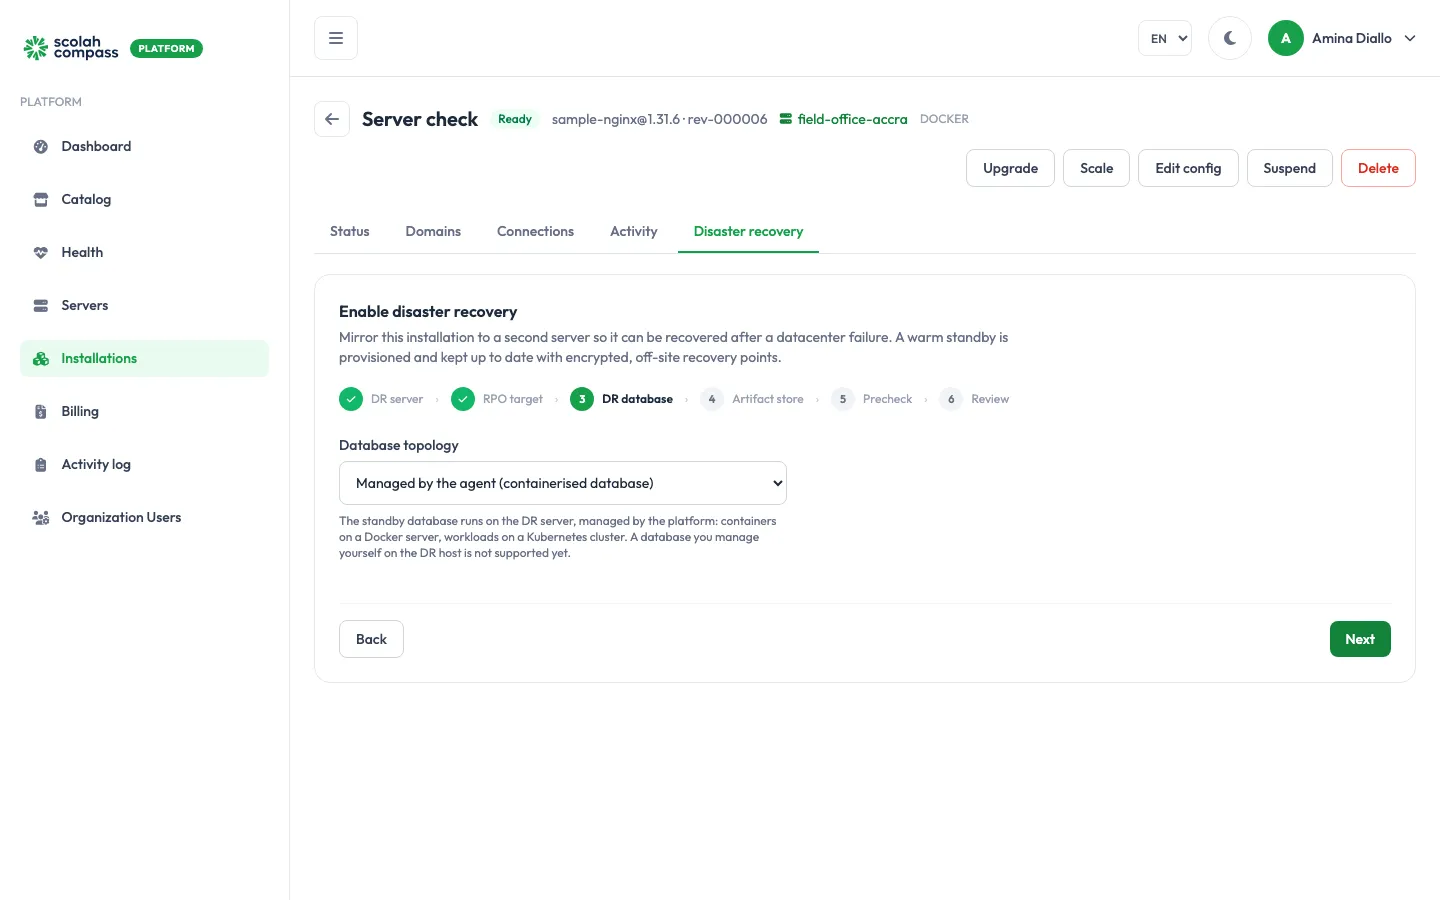
Seção intitulada “3. Banco de dados de recuperação”Topologia do banco de dados define onde os bancos de dados da reserva rodam:
- Gerenciado pelo agente (banco de dados em contêiner), o padrão. O agente executa os bancos de dados da reserva em contêineres, como faz para qualquer instalação.
- Gerenciado por você (seu banco de dados no servidor de recuperação). Os bancos de dados da reserva ficam em um servidor de banco de dados que já roda no servidor de recuperação. Consulte Um banco de dados gerenciado por você.
Um banco de dados gerenciado por você
Seção intitulada “Um banco de dados gerenciado por você”Escolha Gerenciado por você e aparece uma lista com um campo para cada um dos bancos de dados do aplicativo, como postgres ou mongodb. Em cada um, escolha um dos bancos de dados registrados em Serviços externos no servidor de recuperação, do mesmo tipo. Se não houver nenhum desse tipo registrado, o campo informa isso, com um link para a página do servidor de recuperação para você adicionar um. Próximo fica desativado até cada banco de dados ter um.
Se a opção estiver acinzentada, o aplicativo não tem nenhum banco de dados que possa ficar em um servidor gerenciado por você. Os caches e o armazenamento de objetos, como o Redis e o MinIO, sempre ficam com o agente.
Antes de escolhê-la, confirme que:
- o servidor de banco de dados está registrado em Serviços externos no servidor de recuperação
- o Docker no servidor de recuperação consegue alcançá-lo: ele precisa aceitar conexões a partir da rede do Docker, e não apenas de
localhost - a conta registrada tem os direitos para criar os bancos de dados do aplicativo:
- PostgreSQL:
CREATEDB,CREATEROLEe participação empg_signal_backend, ou superusuário - MySQL / MariaDB:
CREATE,DROP,ALTEReGRANT OPTIONnos bancos de dados do aplicativo, além deCREATE USER - MongoDB: uma conta que consiga criar usuários e bancos de dados
- PostgreSQL:
- para um aplicativo que usa PostGIS (DHIS2, HOPE, KoboToolbox), a conta é superusuário, ou o PostGIS está instalado no banco de dados
template1para que todos os novos bancos de dados o tenham. A conta do próprio aplicativo não consegue instalar a extensão - para MySQL com o log binário ativo,
log_bin_trust_function_creatorsestá definido; caso contrário, os triggers e as funções restaurados falham - a versão principal é pelo menos a que o aplicativo usa, por exemplo PostgreSQL 16 ou posterior para um aplicativo em PostgreSQL 16
- os dois servidores são servidores Docker. Clusters não são compatíveis com um banco de dados gerenciado por você
- o servidor de recuperação executa a versão mais recente do agente
Quando você ativa a DR, a plataforma cria os bancos de dados do aplicativo e uma conta proprietária para ele no seu servidor de banco de dados, como faria para uma instalação que usasse esse servidor. Cada restauração substitui esses bancos de dados, e tudo o que é restaurado pertence à conta do aplicativo. No PostgreSQL, a conta registrada passa a ser membro da conta do aplicativo para poder gerenciar esses bancos de dados, e continua sendo.
Nenhuma cópia de reversão dos dados anteriores é mantida no seu servidor. Os pontos de recuperação no seu armazenamento de artefatos são a reversão: para voltar atrás, restaure um anterior. Se você desativar a DR, os bancos de dados permanecem no seu servidor; remova-os quando não precisar mais deles.
Depois que você ativa a DR, e antes do primeiro backup, o agente do servidor de recuperação verifica o banco de dados: se consegue alcançá-lo, os direitos da conta registrada e a versão dele. A aba Recuperação de desastres mostra o resultado de cada verificação, em Verificações do banco de dados que você gerencia. Se uma verificação falhar, a instalação mostra Não protegido com o motivo. Corrija o banco de dados e clique em Executar a verificação novamente.
4. Armazenamento de artefatos
Seção intitulada “4. Armazenamento de artefatos”Onde os pontos de recuperação criptografados são gravados:
| Campo | O que informar |
|---|---|
| URL do endpoint | O endereço do serviço compatível com S3, como https://s3.eu-west-1.amazonaws.com ou o endereço do seu MinIO. |
| Bucket / caminho | O bucket, opcionalmente com uma pasta, como dr-backups/this-org. Use uma pasta diferente para cada instalação protegida. |
| ID da chave de acesso / Chave de acesso secreta | Uma chave que consiga ler e gravar nesse bucket. |
| Senha do repositório | Criptografa os pontos de recuperação. Guarde-a em um local seguro: sem ela, ninguém consegue lê-los. |
| Chave de recuperação (opcional) | Uma segunda senha que também abre os pontos de recuperação. Guarde-a em um local seguro fora dos dois servidores, para que os backups continuem legíveis se o servidor de recuperação for perdido. |
| O Object Lock está ativado neste bucket | Marque apenas se o bucket foi criado com Object Lock (WORM), para que os pontos de recuperação não possam ser excluídos nem substituídos. |
| Período de bloqueio (dias) | Aparece quando você marca o Object Lock e então passa a ser obrigatório: o período de retenção do Object Lock do bucket, um número inteiro de 1 a 3650. Os pontos de recuperação mais recentes do que esse período nunca são removidos. Consulte Por quanto tempo os pontos de recuperação são mantidos. |
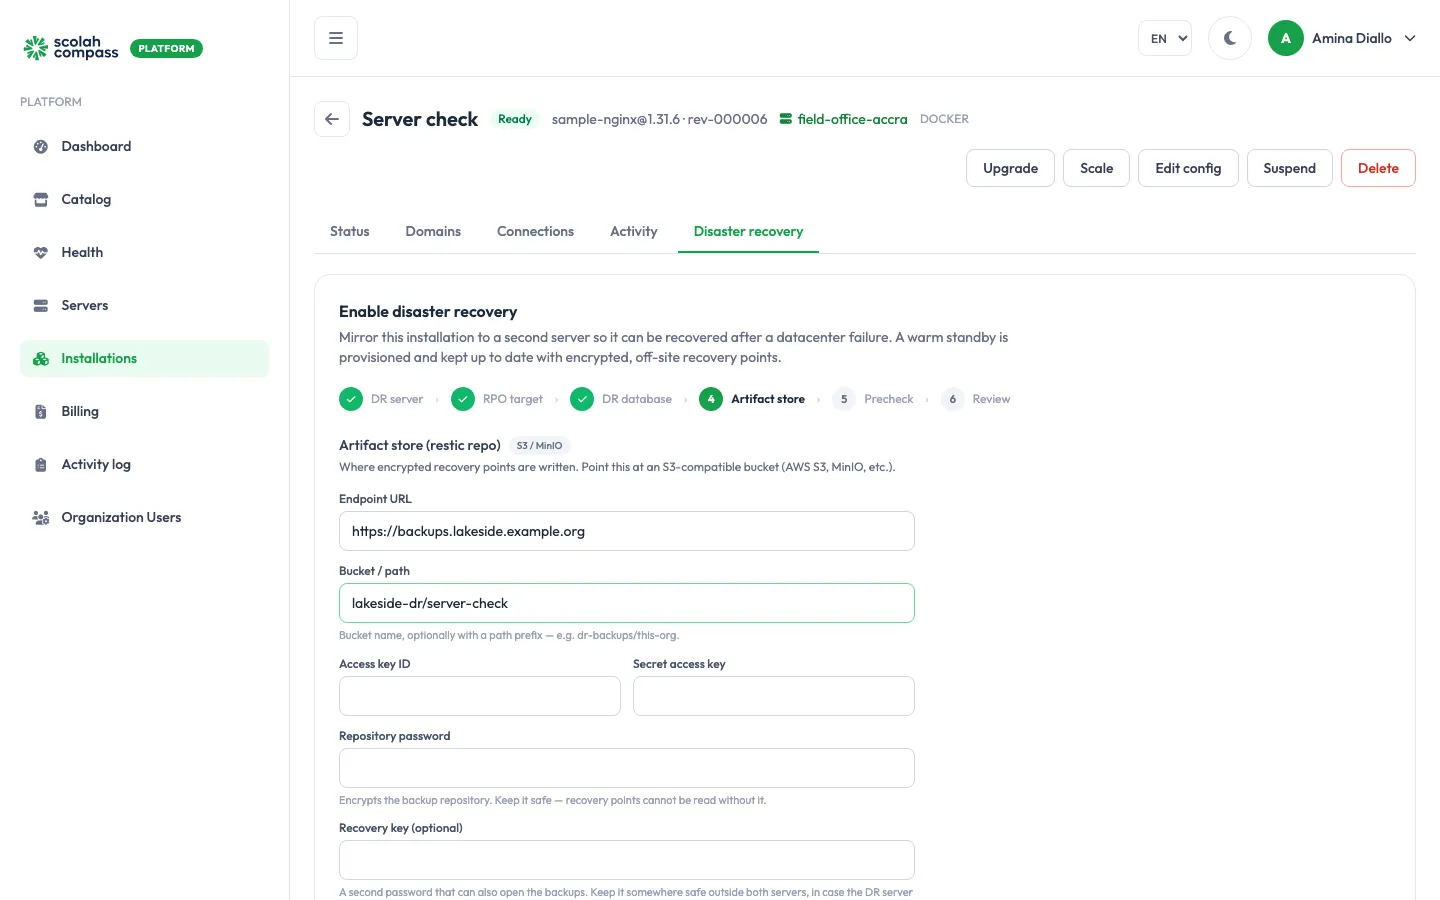
Se você deixar o endpoint e o bucket em branco, os pontos de recuperação ficam armazenados em um repositório local no próprio servidor da instalação, e a revisão mostra Repositório local (desenvolvimento). O servidor de recuperação não consegue restaurar a partir desse repositório, então a reserva nunca é atualizada, e os pontos de recuperação se perdem junto com o servidor. Use-o apenas para testes: para proteger uma instalação, defina um armazenamento de artefatos. Se um dos servidores for um cluster Kubernetes, você precisa definir um.
5. Pré-verificação
Seção intitulada “5. Pré-verificação”A plataforma verifica se a DR pode funcionar e lista cada resultado. Um X vermelho bloqueia você; corrija o problema e clique em Executar pré-verificações novamente. Um aviso não bloqueia.
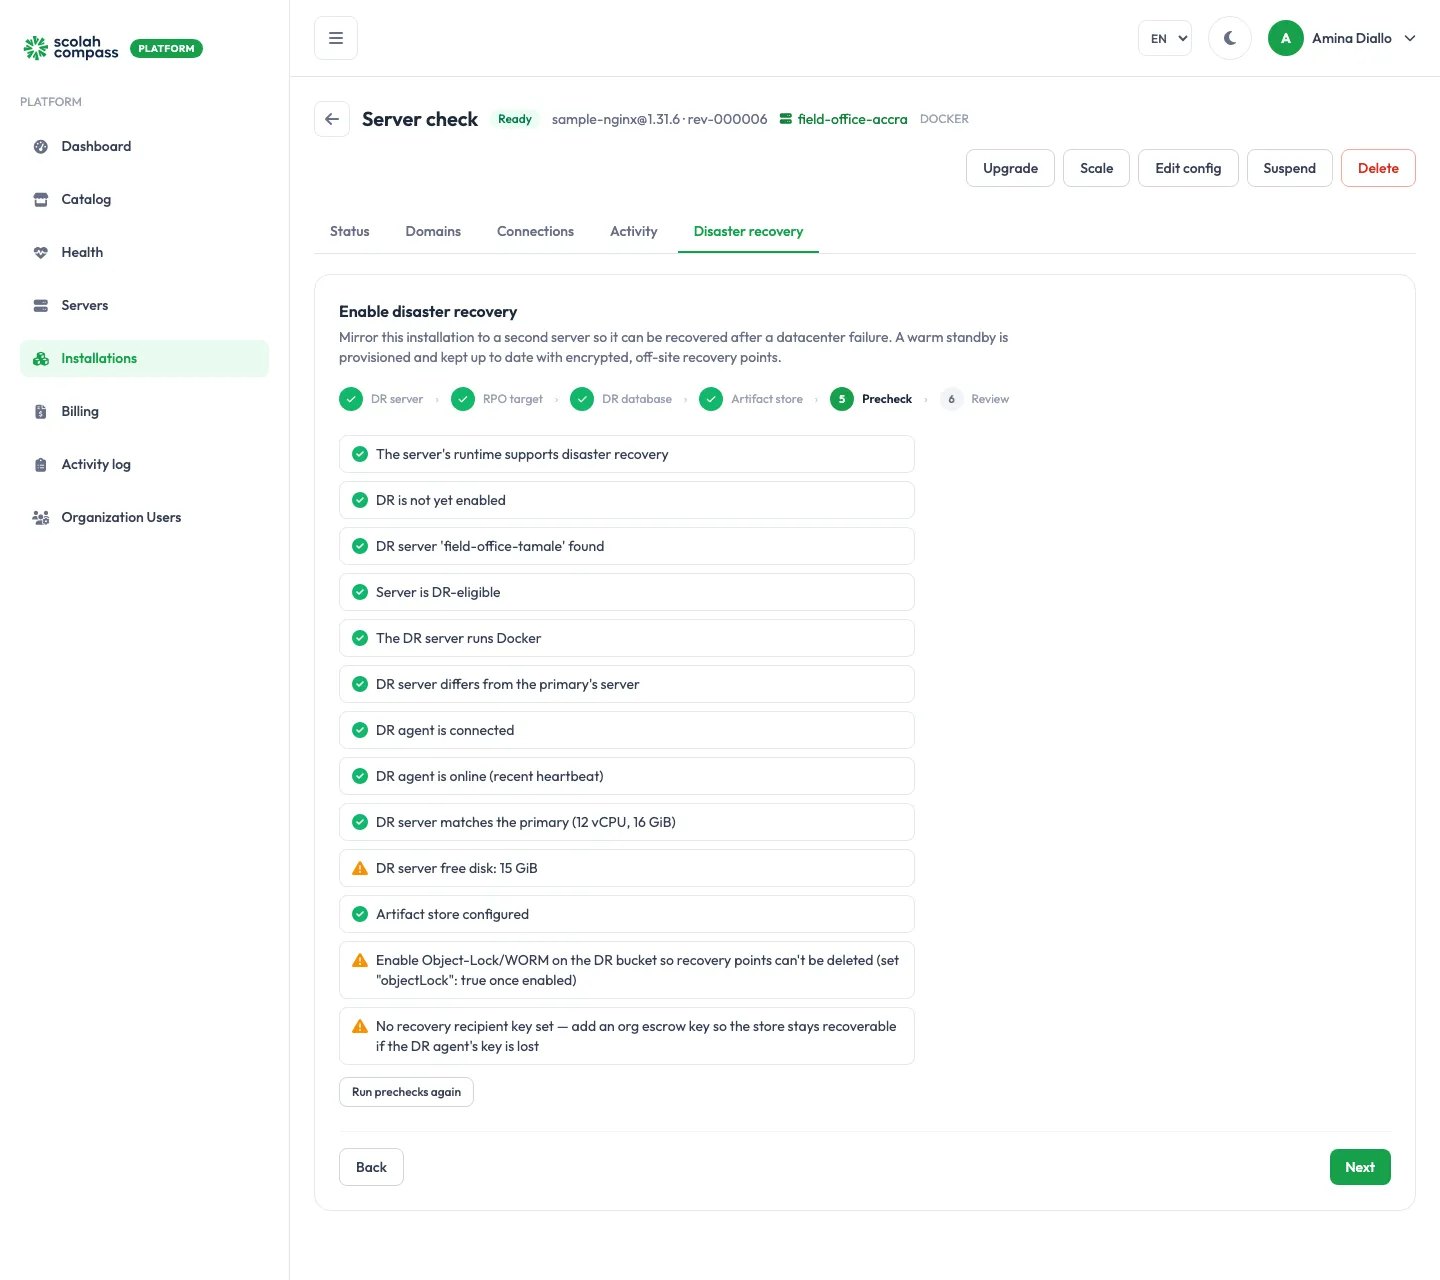
| Verificação | Falha ou avisa quando |
|---|---|
| Already enabled | A DR já está ativa para esta instalação. |
| DR server | O servidor não é encontrado, não é elegível para recuperação ou é o próprio servidor da instalação. |
| DR agent | Não há nenhum agente registrado no servidor de recuperação, ou ele não enviou sinal nos últimos 5 minutos. |
| Capacity | O servidor de recuperação tem menos núcleos de CPU ou menos memória do que o servidor da instalação. Em vez de falhar, avisa quando um servidor ainda não informou seus recursos. |
| Disk | Menos de 10 GiB livres falha; menos de 50 GiB avisa. |
| Artifact store | Avisa quando nenhum está definido, porque o servidor de recuperação não consegue restaurar a partir de um repositório local. Nesse caso, falha quando um dos servidores é um cluster Kubernetes. Quando há um armazenamento definido, também avisa quando O Object Lock está ativado neste bucket não está marcado e quando nenhuma Chave de recuperação (opcional) é informada. |
| Database you manage | Apenas com Gerenciado por você. Falha quando um dos servidores é um cluster Kubernetes, quando o agente do servidor de recuperação é antigo demais ou quando não foi escolhido um banco de dados registrado do tipo certo para algum banco de dados. |
| Database you manage on the original server | A própria instalação usa um banco de dados gerenciado por você (consulte Limitações). |
| Connections | Avisa quando a instalação tem conexões. Elas a acompanham no failover, mas as instalações que ficam no servidor original as perdem até também mudarem. |
Marque O Object Lock está ativado neste bucket e informe uma Chave de recuperação (opcional), e esses dois avisos desaparecem na próxima pré-verificação. De qualquer forma, eles não impedem você de ativar a DR. A chave de recuperação é adicionada ao repositório como segunda chave quando a DR é ativada.
6. Revisão
Seção intitulada “6. Revisão”Confira o resumo e clique em Ativar recuperação. Com o Object Lock marcado, o resumo também mostra o Período de bloqueio (dias).
O que acontece depois
Seção intitulada “O que acontece depois”A reserva aparece em Instalações no servidor de recuperação, por exemplo Programme analytics (RD). Ela mostra Em reserva: seus bancos de dados ficam rodando e aguardam ficar íntegros, e o aplicativo em si não roda ali.
A aba Recuperação de desastres mostra Sincronizando. O primeiro backup é feito em um ou dois minutos. Depois que ele é enviado, o status passa para Sincronizado e o título para Protegido. Um minuto depois, o servidor de recuperação o restaura na reserva, e a primeira verificação diária é feita.
Monitorar a proteção
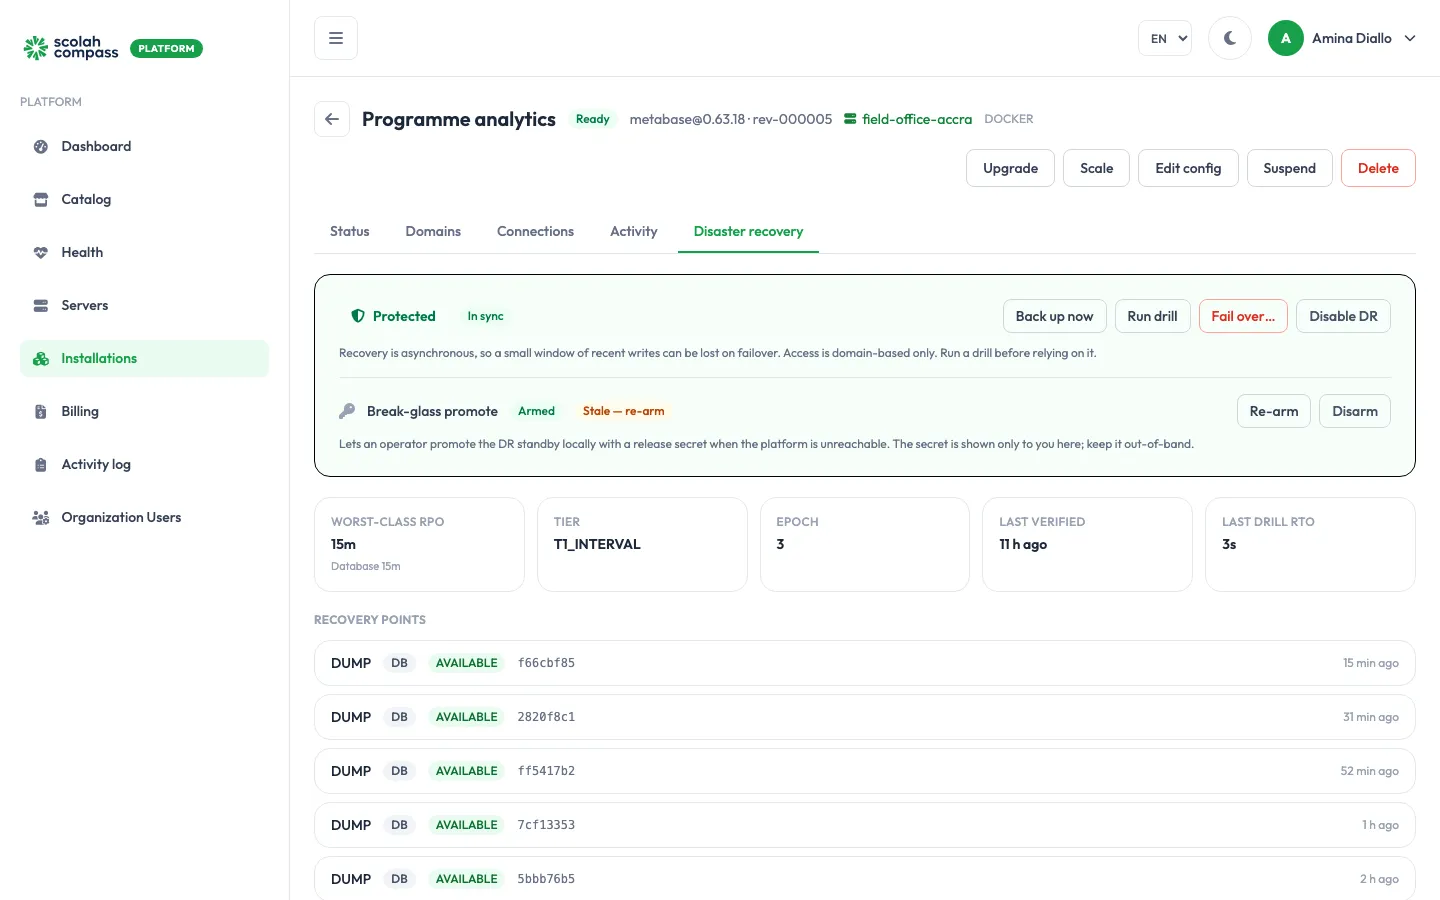
Seção intitulada “Monitorar a proteção”A aba Recuperação de desastres da instalação protegida mostra:
- Um título: Protegido (verde) quando o status é Sincronizado ou Promovido; caso contrário, Não protegido (vermelho).
- RPO pior classe: a idade do ponto de recuperação mais recente, dividida por Banco de dados e, se o aplicativo tiver arquivos, Arquivos. Em Contínuo, é o banco de dados mais lento.
- Nível (Intervalo ou Contínuo) e Época (um contador que aumenta a cada failover e retorno ao primário).
- Última verificação: quando a verificação diária foi aprovada pela última vez.
- RTO do último teste: quanto tempo a restauração levou no último teste, em segundos.
- O seletor Nível e a Verificação dos bancos de dados. Consulte Nível Contínuo.
- Pontos de recuperação, do mais recente para o mais antigo, com o tipo (DUMP para bancos de dados, FILES para arquivos, SNAPSHOT_BASE para uma base do nível Contínuo), o status e a idade.
| Status | Significado |
|---|---|
| Sincronizando | Ativada, aguardando o primeiro ponto de recuperação. |
| Sincronizado | Os pontos de recuperação estão chegando. |
| Desatualizado | A verificação diária do ponto de recuperação mais recente falhou. Volta para Sincronizado quando uma verificação posterior for aprovada. Não confie na reserva até lá. |
| Fazendo failover | Um failover está em andamento. |
| Promovido | A reserva agora é a instalação ativa. |
| Revertendo | O serviço está sendo devolvido à instalação original. |
| Falhou | Um failover não conseguiu colocar a reserva para funcionar. A instalação original continua atendendo. |
Um ponto de recuperação fica AVAILABLE quando é enviado, VERIFIED assim que a verificação diária o restaura com sucesso e CORRUPT se essa verificação falhar.
Por quanto tempo os pontos de recuperação são mantidos
Seção intitulada “Por quanto tempo os pontos de recuperação são mantidos”Uma vez por dia, o agente no servidor original exclui os pontos de recuperação que não são mais necessários e libera o espaço que eles ocupavam no bucket:
- Todos os backups das últimas 48 horas são mantidos.
- Depois disso, é mantido um backup por dia durante 30 dias.
- Os backups com mais de 30 dias são excluídos.
Os pontos de recuperação dos bancos de dados e dos arquivos são contados separadamente, e o mais recente nunca é excluído. Um ponto excluído deixa de aparecer em Pontos de recuperação.
Em Contínuo, as bases físicas e as alterações enviadas desde então são mantidas por 7 dias, mais o que a base mantida mais antiga ainda precisar para ser reproduzida. Essa é a janela que um teste até um momento específico consegue alcançar: aproximadamente os últimos 7 dias. Os backups diários são mantidos como descrito acima.
Se o bucket usar Object Lock, a limpeza nunca remove um ponto de recuperação mais recente do que o Período de bloqueio (dias) informado na etapa 4, mesmo quando as regras acima o fariam. Um ponto de recuperação que o bucket ainda se recuse a excluir continua na lista, e uma execução posterior o exclui quando o bloqueio expirar. Informe o período de retenção real do bucket: a plataforma não o lê do bucket.
A limpeza diária espera terminar um backup ou uma restauração em andamento, e não é executada durante um failover ou uma reversão.
A página Saúde também lista todas as instalações protegidas e gera um alerta quando a proteção está falhando ou os pontos de recuperação param de chegar.
Nível Contínuo
Seção intitulada “Nível Contínuo”No nível Contínuo (T2), o agente do servidor original coleta continuamente as alterações de cada banco de dados e as envia para o armazenamento de artefatos a cada 2 minutos, aproximadamente. A cada 6 horas, ele também envia uma base: uma cópia completa do banco de dados sobre a qual as alterações são reproduzidas. O servidor de recuperação reproduz cada novo lote na reserva, que se mantém como uma cópia a quente logo atrás da original. Normalmente você perde de 1 a 3 minutos de dados.
| Mecanismo | Alterações enviadas | Base |
|---|---|---|
| PostgreSQL | Seu log de escrita antecipada (WAL), lido a partir de um slot de replicação | Uma cópia física do banco de dados |
| MariaDB | Seu log binário (binlog) | Um dump lógico que registra a posição do binlog no momento em que foi feito |
No MariaDB, o servidor de recuperação aplica os binlogs ao banco de dados em execução da reserva. Os testes até um momento específico e o failover funcionam como no PostgreSQL.
Nada é enviado diretamente de um local para o outro: os dois agentes só se comunicam com o armazenamento de artefatos, assim como em Intervalo. Mudar para Contínuo não reinicia nada no servidor original. No PostgreSQL, a única configuração do banco de dados alterada é o limite do slot de replicação descrito abaixo. Em um cluster, o agente também acrescenta uma linha de replicação ao pg_hba.conf do PostgreSQL, que também não exige reinício. O MariaDB não precisa de nenhuma alteração desse tipo, em nenhum tipo de servidor.
Antes de mudar para Contínuo
Seção intitulada “Antes de mudar para Contínuo”-
O plano da sua organização o inclui. A Scolah concede o nível Contínuo por organização, e um acréscimo no faturamento se aplica à parte de DR de uma instalação que o use (consulte Faturamento). Até lá, a aba informa O plano da sua organização não inclui o nível Contínuo. Entre em contato com seu representante Scolah.
-
A verificação diária mostra todos os bancos de dados enviados continuamente como prontos. Uma vez por dia, o agente do servidor original verifica cada banco de dados que o aplicativo envia continuamente. No PostgreSQL:
wal_leveléreplicaoulogical(o valor padrão dos bancos de dados incluídos)- há um slot de replicação e um emissor de WAL livres (
max_replication_slots,max_wal_senders) - sua conta tem
REPLICATIONou é superusuário - uma conexão de replicação funciona
Em um servidor Docker, o agente se conecta pela rede de contêineres do próprio banco de dados, então os bancos de dados incluídos não precisam de nenhuma alteração no
pg_hba.conf. Em um cluster, o agente acrescenta uma linha a ele: consulte Nível Contínuo com o primário em um cluster.No MariaDB:
- o log binário está ativo (
log_bin) - o formato do binlog é por linha (
binlog_formatéROW) - sua conta tem as permissões
REPLICATION SLAVEeREPLICATION CLIENT(BINLOG MONITORnas versões mais recentes do MariaDB)
Os bancos de dados incluídos do ERPNext e do OpenMRS atendem a tudo isso. Em uma instalação criada antes de o log binário ser acrescentado a eles, atualizar a instalação o ativa, o que reinicia o banco de dados uma vez.
-
O servidor é MariaDB. Os servidores Oracle MySQL não podem usar o nível Contínuo e ficam em Intervalo.
-
Qualquer um dos servidores pode ser um cluster Kubernetes, tanto para o PostgreSQL quanto para o MariaDB. A instalação original e o servidor de recuperação podem, cada um, executar Docker ou ser um cluster: consulte Nível Contínuo com o primário em um cluster e Nível Contínuo com o servidor de recuperação em um cluster.
-
Os bancos de dados da reserva são gerenciados pelo agente. O nível Contínuo não está disponível com um banco de dados gerenciado por você no servidor de recuperação.
-
Os dois servidores têm a versão mais recente do agente.
Mudar para Contínuo
Seção intitulada “Mudar para Contínuo”- Abra a aba Recuperação de desastres da instalação protegida.
- Em Nível, clique em Contínuo (T2). Se estiver acinzentado, os motivos aparecem abaixo: o plano, um banco de dados gerenciado por você, um problema no cluster de um dos servidores (por exemplo The Continuous tier can’t run on this pairing’s cluster yet: The DR cluster has no default StorageClass for the standby’s work volumes) ou o problema exato que a verificação diária encontrou em cada banco de dados, por exemplo wal_level is minimal; replica or logical is needed.
- Confirme. A plataforma primeiro faz uma base física e depois começa a enviar as alterações.
Para voltar atrás, clique em Intervalo (T1) e confirme. O envio para. No PostgreSQL, o slot de replicação é removido do banco de dados do servidor original e, em um cluster, o agente também remove sua linha do pg_hba.conf. Em um cluster, o pod expedidor e o volume dele são excluídos, tanto para PostgreSQL quanto para MariaDB.
O que a aba mostra em Contínuo
Seção intitulada “O que a aba mostra em Contínuo”- RPO pior classe é o banco de dados mais lento.
- Uma tabela com uma linha por banco de dados: o nível (Contínuo para um banco enviado continuamente, Intervalo para os outros), o RPO e:
- no PostgreSQL, o Atraso do slot, ou seja, quanto WAL o servidor original está guardando para o slot, exibido como x de 10 GB, e o Status do WAL do slot:
reservedé normal,extendedsignifica que ultrapassou o tamanho habitual do WAL, eunreservedoulostsignifica que o primário está excluindo WAL de que a reserva ainda precisa. - no MariaDB, quanto binlog ainda não foi enviado, exibido como x ainda por enviar. Não há slot, então não há limite nem status do WAL. O único selo é um vermelho Binlog excluído no primário quando o servidor original apagou um binlog antes de ele ser enviado.
- no PostgreSQL, o Atraso do slot, ou seja, quanto WAL o servidor original está guardando para o slot, exibido como x de 10 GB, e o Status do WAL do slot:
- Verificação dos bancos de dados: quando a verificação diária foi executada pela última vez e, para cada banco de dados, o mecanismo e a versão, o tamanho e Pronto para Contínuo, Permanece em Intervalo (os bancos de dados que o aplicativo não envia continuamente, como o MongoDB) ou o problema encontrado. As notas em âmbar abaixo apontam o que não impede o nível Contínuo, por exemplo que não foi possível verificar a arquitetura de CPU de um banco de dados de reserva em um cluster de recuperação com arquiteturas mistas.
- Um aviso quando os últimos 1 ou 2 envios falharam.
Retorno automático para Intervalo
Seção intitulada “Retorno automático para Intervalo”O nível Contínuo volta sozinho para Intervalo, e a aba mostra O nível Contínuo voltou a Intervalo com o motivo, quando:
- 3 envios seguidos falham
- o slot de replicação se perde no servidor original
- um binlog do MariaDB é excluído no servidor original antes de ser enviado (consulte Os binlogs do MariaDB)
- o plano da sua organização deixa de incluir o nível Contínuo
- a verificação diária deixa de mostrar todos os bancos de dados prontos
Os backups continuam em Intervalo, então a instalação continua protegida, com o RPO do Intervalo. Enquanto a plataforma remove o slot de replicação do banco de dados do servidor original, a aba mostra Limpando o slot de replicação no servidor principal…. Corrija a causa e mude para Contínuo de novo. Se a limpeza falhar, a plataforma tenta novamente, esperando mais tempo a cada vez (até uma hora), e a nota informa quantas vezes ela falhou, quando será a próxima tentativa e o último erro, palavra por palavra. Após 3 tentativas com falha, a página Saúde gera dr-cleanup-pending com o número de falhas e o último erro, até a limpeza ser concluída com sucesso. A página Saúde gera dr-demoted até você escolher um nível.
O slot de replicação e o disco do primário
Seção intitulada “O slot de replicação e o disco do primário”Um slot de replicação obriga o banco de dados do servidor original a guardar o WAL que o agente ainda não enviou. Se o envio parar, esse WAL cresceria até encher o disco. Para proteger o disco, a plataforma limita o slot a 10 GB (max_slot_wal_keep_size). Acima do limite, o banco de dados exclui o WAL mais antigo: o slot se perde e o nível Contínuo volta para Intervalo, mas a instalação original continua funcionando.
A página Saúde avisa com dr-slot-lag quando o slot chega à metade do limite, e gera dr-slot-at-risk quando o status do WAL dele é unreserved ou lost. Garanta que o disco do servidor original tenha pelo menos 10 GB livres além do que o banco de dados precisa.
Os binlogs do MariaDB
Seção intitulada “Os binlogs do MariaDB”O MariaDB não tem slot de replicação, então nada obriga o servidor original a guardar um binlog até ele ser enviado. Os bancos de dados incluídos guardam os binlogs por 2 dias (binlog_expire_logs_seconds). Se o envio parar por mais tempo, por exemplo enquanto o agente do servidor original está offline, o banco de dados apaga um binlog de que a reserva ainda precisa. O nível Contínuo então volta imediatamente para Intervalo, e mudar para Contínuo de novo faz uma nova base.
A página Saúde gera dr-slot-at-risk quando isso acontece. Ela nunca gera dr-slot-lag para o MariaDB, porque não há limite a ser preenchido.
Fazer backup agora
Seção intitulada “Fazer backup agora”Fazer backup agora cria um ponto de recuperação imediatamente, em vez de esperar pelo próximo backup de 15 minutos. Use-o antes de uma manutenção planejada no servidor original.
Executar um teste
Seção intitulada “Executar um teste”Um teste confirma que você consegue recuperar sem mexer em nada que esteja em produção. Executar teste restaura o ponto de recuperação mais recente em um banco de dados temporário no servidor de recuperação, verifica-o, exclui-o e registra quanto tempo a restauração levou em RTO do último teste. A reserva e a instalação original continuam funcionando normalmente.
Um teste usa o ponto de recuperação mais recente, esteja ele VERIFIED ou não. Se não houver nenhum, por exemplo logo depois de ativar a DR, o teste é recusado com No recovery point available to drill yet (ainda não há nenhum ponto de recuperação disponível para testar): clique em Fazer backup agora, aguarde um minuto e execute o teste novamente.
Execute um teste depois de ativar a DR, e de novo sempre que os dados da instalação crescerem muito, para saber quanto tempo uma recuperação real levaria.
Testar até um momento específico
Seção intitulada “Testar até um momento específico”Em Contínuo, Executar teste pergunta até onde recuperar:
- O mais recente: tudo o que foi enviado até agora.
- Um momento específico: uma data e hora, no fuso horário do seu navegador, dentro da janela mostrada abaixo do seletor. A janela vai da base física mantida mais antiga até o último envio, aproximadamente os últimos 7 dias. O teste reproduz as alterações até esse momento, verifica o banco de dados e registra o tempo em RTO do último teste.
Um momento no futuro ou fora da janela é recusado com o motivo. Antes da primeira base física, só O mais recente é oferecido. Em Intervalo, um teste sempre usa o ponto de recuperação mais recente.
Em um servidor de DR Docker, o banco de dados temporário do teste roda na mesma imagem de banco de dados que o próprio banco de dados da instalação de DR, com as mesmas bibliotecas pré-carregadas. Assim, os aplicativos que usam PostGIS (DHIS2, HOPE, KoboToolbox), os bancos de dados com bibliotecas pré-carregadas como pg_stat_statements e o PostgreSQL 13 do openIMIS são recuperados exatamente como o banco de dados de reserva roda. Isso requer o agente mais recente.
Fazer failover
Seção intitulada “Fazer failover”Faça failover apenas quando não for possível recuperar rapidamente a instalação original.
- Na aba Recuperação de desastres, clique em Fazer failover…. Está disponível quando o status é Sincronizado ou Desatualizado.
- Leia o aviso. A partir de Desatualizado, a reserva pode não ter dados tão recentes quanto o habitual.
- Digite
FAILOVERe confirme.
A plataforma para o aplicativo no servidor original, se ainda conseguir alcançar o agente desse servidor, e inicia o aplicativo completo na reserva. Quando a reserva está ativa, a plataforma:
- move para ela os domínios da instalação, e o servidor de recuperação passa a atendê-los, com HTTPS de acordo com o modo TLS do domínio
- aponta os registros DNS que gerencia (subdomínios Scolah) para o endereço IP público do servidor de recuperação
- transforma a instalação original na reserva: ela mostra Em reserva, seu aplicativo continua parado e seus domínios são removidos do servidor dela, então o endereço web dela responde HTTP 404, mesmo que esse servidor volte a ficar online mais tarde
O status passa para Promovido. Se a reserva não iniciar, o status passa para Falhou e a instalação original continua atendendo.
Em Contínuo, o servidor de recuperação primeiro reproduz tudo até o último envio e só depois promove os bancos de dados da reserva. O failover sempre recupera até o último envio: não é possível fazer failover para um momento anterior.
Se você usar seu próprio domínio, confirme que o registro A aponta para o endereço IP público do servidor de recuperação e, se não apontar, altere-o no seu provedor de DNS. A aba Domínios da instalação promovida mostra cada domínio como Encaminhado assim que o servidor de recuperação passa a atendê-lo.
Voltar ao primário
Seção intitulada “Voltar ao primário”Depois de um failover, assim que o servidor original estiver íntegro de novo, você pode devolver o serviço a ele.
- Clique em Voltar ao primário…. Só aparece quando o status é Promovido.
- Digite
FAILBACKe confirme.
A plataforma, passo a passo:
- faz um backup da instalação original no estado em que ela está, como backup de precaução
- faz um backup dos dados atuais da reserva promovida
- restaura esses dados na instalação original, substituindo o banco de dados dela
- inicia a instalação original e para o aplicativo na reserva
- move de volta os domínios e o DNS e devolve a reserva ao papel de reserva
O status é Revertendo enquanto isso acontece e depois Sincronizado. Se alguma etapa falhar, o processo para, o status volta para Promovido e a reserva continua atendendo.
O retorno ao primário sempre copia os dados com um backup lógico, mesmo em Contínuo. Depois, uma instalação em Contínuo faz uma nova base física e recomeça os envios, então a janela de um teste até um momento específico recomeça a partir daí.
Promoção de emergência
Seção intitulada “Promoção de emergência”Um failover normal precisa da plataforma. A promoção de emergência permite que alguém no servidor de recuperação promova a reserva mesmo quando a plataforma está inacessível.
-
Enquanto tudo estiver funcionando, clique em Armar em Promoção de emergência e defina um Segredo de desbloqueio. Guarde o segredo em um local que seus operadores consigam acessar durante uma falha, e não apenas no portal.
-
O agente do servidor de recuperação guarda um token de promoção assinado, válido por 90 dias a partir do momento em que você o arma. Se a reserva mudar, o status mostra Desatualizada — rearmar: clique em Rearmar.
-
Em uma emergência, no servidor de recuperação, execute:
Terminal window scolah-agent break-glass promote --secret <release secret>O agente verifica o token e o segredo e depois inicia o aplicativo completo na reserva. Quando a plataforma voltar a alcançar o agente, ela conclui o failover como se você o tivesse iniciado pelo portal: move os domínios, transforma a instalação original na reserva, e o status passa para Promovido.
Até lá, nada para a instalação original nem altera o DNS. Certifique-se de que a original está realmente fora do ar e aponte você mesmo seu domínio para o servidor de recuperação se as pessoas precisarem dela antes de a plataforma voltar.
Desarmar retira o token do servidor de recuperação.
Desativar a recuperação de desastres
Seção intitulada “Desativar a recuperação de desastres”Clique em Desativar recuperação e confirme. A reserva é removida do servidor de recuperação, com seus dados, e a lista de pontos de recuperação é limpa. Se a reserva usava um banco de dados gerenciado por você, os bancos de dados correspondentes no seu servidor são mantidos. A instalação original não é afetada. Os backups já enviados ficam no seu bucket até você excluí-los.
Em Contínuo, desativar a DR também limpa o servidor original: o slot de replicação é removido do banco de dados dele e, em um cluster, também a linha do pg_hba.conf e o pod expedidor com o volume dele. Se o servidor original estiver offline, a limpeza é feita automaticamente assim que o agente dele voltar a ficar online. Até lá, o slot obriga o banco de dados a guardar o WAL, até o limite. Se a limpeza falhar, a plataforma continua tentando. A página Saúde gera dr-cleanup-pending após 3 tentativas com falha, com o número de falhas e o último erro, ou 10 minutos depois de a DR ser desativada se o agente do servidor original continuar offline, e o alerta desaparece quando a limpeza é concluída com sucesso.
Enquanto essa limpeza não terminar, o nível Contínuo não pode ser ativado para um novo pareamento de DR de uma instalação no mesmo servidor original: ele é recusado com uma mensagem que indica o slot de replicação do pareamento anterior que ainda falta limpar. O Intervalo funciona normalmente nesse meio-tempo.
Você não pode desativar a DR enquanto um failover ou um retorno ao primário estiver em andamento, nem enquanto a reserva estiver promovida.
Faturamento
Seção intitulada “Faturamento”A reserva conta como uma instalação própria, com dias ativos como qualquer outra. Em Faturamento → Uso, a linha dela está marcada com DR. A Scolah cobra os dias dela a uma fração reduzida da tarifa do aplicativo, sem taxa de implantação, e um aplicativo gratuito continua gratuito. Consulte Faturamento.
Em Contínuo, uma porcentagem é acrescentada à parte de DR.
A fração reduzida sempre se aplica ao lado que não está atendendo. Depois de um failover, a instalação promovida é cobrada pela tarifa completa e a original, agora a reserva, pela fração reduzida, até o retorno ao primário.
Clusters Kubernetes
Seção intitulada “Clusters Kubernetes”Um cluster Kubernetes pode participar da recuperação de desastres dos dois lados. Uma instalação em um cluster pode ser protegida, e um cluster pode hospedar reservas depois de marcado como elegível para recuperação. Você pode parear um servidor Docker com um cluster em qualquer sentido, ou dois clusters entre si.
Ative a DR como para qualquer instalação. Quando um cluster está envolvido:
- Um armazenamento de artefatos é obrigatório. Sempre que um dos servidores é um cluster, o armazenamento de artefatos é a única coisa que os dois servidores compartilham, por isso a pré-verificação falha sem ele.
- Os backups rodam no cluster. A cada 15 minutos, um pod de curta duração no namespace da instalação faz um backup dos bancos de dados e dos volumes de arquivos, como a pasta de dados do Moodle, e o envia no mesmo formato que um servidor Docker. Um ponto de recuperação criado em um cluster pode ser restaurado em uma reserva Docker, e vice-versa.
- Uma reserva em um cluster mantém os bancos de dados rodando enquanto as cargas de trabalho do aplicativo ficam reduzidas a zero, e não tem rota. Seu recurso
Installationmostra a faseStandby. - O nível Contínuo funciona para PostgreSQL e MariaDB dos dois lados. Um primário Docker com uma reserva em um cluster, um cluster com uma reserva Docker e dois clusters entre si funcionam todos. Consulte Nível Contínuo com o primário em um cluster e Nível Contínuo com o servidor de recuperação em um cluster.
- Os testes e a verificação diária rodam na reserva, onde quer que ela esteja. Em um cluster, eles rodam no namespace da reserva e limpam o que criaram, e o tempo de restauração do teste aparece em RTO do último teste, assim como em um servidor Docker.
O failover e o retorno ao primário funcionam como descrito acima, em um cluster da mesma forma que em um servidor Docker. A instalação que assume o serviço recebe os domínios; a que cede o lugar perde sua rota, então o endereço web dela responde HTTP 404. No retorno ao primário para um cluster, a instalação original é reativada sem rotas, recebe um backup de precaução, é carregada com os dados do servidor de recuperação, e seus pods do aplicativo são reiniciados antes de os domínios serem devolvidos a ela.
Nível Contínuo com o primário em um cluster
Seção intitulada “Nível Contínuo com o primário em um cluster”Uma instalação em um cluster Kubernetes pode usar o nível Contínuo, quer seu servidor de recuperação execute Docker, quer também seja um cluster. Seus bancos de dados PostgreSQL enviam o WAL, e os MariaDB o binlog, assim como em um servidor Docker, e o servidor de recuperação os reproduz na reserva da mesma forma. Os envios, as bases, os testes até um momento específico, o failover e a aba funcionam todos como em um servidor Docker.
Antes de mudar, o cluster da instalação original precisa de:
- Agente 0.0.2 ou mais recente no cluster.
- A imagem do próprio agente disponível para pull a partir do namespace da instalação. Algumas etapas do nível Contínuo rodam em pods de curta duração que usam a imagem do agente: consulte Registros privados em um cluster.
- Uma StorageClass padrão com espaço para o volume do expedidor: o limite do slot (10 GB) mais 2 GB por banco de dados enviado continuamente.
- A mesma arquitetura de CPU que o servidor de recuperação. A plataforma verifica o nó onde cada banco de dados de fato roda, então a verificação é exata mesmo em um cluster que mistura arquiteturas. Uma diferença bloqueia o nível Contínuo, por exemplo The database of store db runs on an arm64 node and the DR server on amd64.
Para o PostgreSQL, também:
- Uma conta de banco de dados que seja superusuário. Os bancos de dados incluídos usam uma.
- O
pg_hba.confno diretório de dados do banco de dados, como nas imagens oficiais do PostgreSQL. - Uma regra geral
host all all allnopg_hba.conf. O agente reutiliza o método de autenticação dela. - Um volume do banco de dados que não seja
ReadWriteOncePod. O nível Contínuo o monta a partir de um segundo pod no mesmo nó.
Para o MariaDB, também:
- O log binário ativo, no formato por linha, e uma conta com as permissões
REPLICATION SLAVEeREPLICATION CLIENT(ouBINLOG MONITOR), como indicado em Antes de mudar para Contínuo. Os bancos de dados incluídos do ERPNext e do OpenMRS já vêm assim.
Se faltar algum desses itens, Contínuo (T2) fica acinzentado e o motivo aparece abaixo, por exemplo The Continuous tier can’t run on this pairing’s cluster yet: The cluster has no default StorageClass for the WAL shipper’s volume, ou The cluster’s agent is 0.0.1; streaming MariaDB on a cluster needs agent 0.0.2 or later.
Para o PostgreSQL, o agente acrescenta duas coisas ao cluster:
- Uma linha no
pg_hba.conf. As imagens PostgreSQL upstream recusam conexões de replicação vindas de outros pods, por isso o agente acrescenta uma linha que permite à conta do banco de dados replicar, por exemplohost replication "postgres" all scram-sha-256 # scolah-dr 1a2b3c4d. O método é o da sua regra geral, e o comentário identifica a linha como sendo da plataforma. O agente a grava via SQL e recarrega a configuração, então o banco de dados não é reiniciado. Se o PostgreSQL depois apontar um erro no arquivo, o agente restaura o original. A linha permite a replicação apenas para essa conta, a partir de qualquer ponto que alcance o Service do banco de dados, com o método de autenticação que o aplicativo já usa, então ela não abre mais do que o acesso do próprio aplicativo. Quando você volta para Intervalo ou desativa a DR, o agente remove a linha e recarrega de novo, também sem reiniciar. Cada adição e cada remoção fica registrada no Registro de atividades comodr.pg_hba.line_addedoudr.pg_hba.line_removed, na instalação original, com o banco de dados e o checksum do arquivo antes e depois da alteração. Quando o checksum depois de uma remoção coincide com o de antes da adição, o arquivo foi restaurado byte a byte. - Um pod expedidor,
scolah-drship-<base>, no namespace da instalação. Ele recebe o WAL e o guarda até o próximo envio, em um volume próprio da StorageClass padrão, com o tamanho do limite do slot mais 2 GB. O pod, o volume e o secret são excluídos quando o nível Contínuo é desativado.
Para o MariaDB, o agente acrescenta apenas um pod expedidor, scolah-drship-<base>, com volume próprio (o limite do slot mais 2 GB, da StorageClass padrão) e secret. Ele lê o binlog pelo Service do banco de dados, como uma réplica faria, e o guarda até o próximo envio. Nada muda no banco de dados: as permissões de replicação já permitem a leitura remota do binlog, então não há nenhuma alteração no estilo do pg_hba.conf nem reinício. O pod, o volume e o secret são excluídos quando o nível Contínuo é desativado.
Registros privados em um cluster
Seção intitulada “Registros privados em um cluster”A recuperação de desastres faz seu trabalho em pods de curta duração no namespace da instalação: backups, restaurações, preparação, testes em um momento específico e o expedidor do nível Contínuo. Eles usam a imagem do próprio agente e as imagens dos bancos de dados do aplicativo, e cada um faz o pull das imagens com estes dois Secrets, quando existem:
scolah-registry-auth, a credencial de registro da instalação, que o agente já grava para os aplicativos com imagens privadas.scolah-dr-agent-pull, uma cópia dosimagePullSecretsdefinidos no chart Helm do agente. Um pod não pode usar um Secret de outro namespace, por isso o agente copia os pull secrets do chart para o namespace de cada instalação antes de iniciar um desses pods, e deixa a cópia lá.
Se a imagem do agente estiver em um registro privado, defina imagePullSecrets no chart do agente, por exemplo --set 'imagePullSecrets[0].name=my-registry', com esse Secret em scolah-system. Se a cópia falhar, o agente registra isso em log e inicia o pod sem ela, então uma imagem pública continua funcionando.
Nível Contínuo com o servidor de recuperação em um cluster
Seção intitulada “Nível Contínuo com o servidor de recuperação em um cluster”Uma reserva em um cluster Kubernetes pode usar o nível Contínuo para PostgreSQL e MariaDB, quer a instalação original rode em um servidor Docker, quer em um cluster. A reserva reproduz o WAL ou o binlog enviado assim como em um servidor Docker, e os testes até um momento específico, a promoção no failover e a aba funcionam da mesma forma.
Antes de mudar, o cluster de recuperação precisa de:
- Agente 0.0.2 ou mais recente no cluster de recuperação.
- A imagem do próprio agente disponível para pull a partir do namespace da reserva, assim como do lado do primário.
- Uma StorageClass padrão. A preparação da reserva e os testes usam volumes de trabalho de curta duração criados a partir dela.
- A mesma arquitetura de CPU que o servidor original. Quando todos os nós do cluster de recuperação compartilham uma arquitetura, a plataforma compara essa. Em um cluster que mistura arquiteturas, ela não consegue saber em qual nó o banco de dados de reserva vai rodar antes que ele rode, por isso compara o nó onde roda o agente de recuperação e a aba mantém uma nota em âmbar. Fixe o banco de dados de reserva na arquitetura do banco de dados original, por exemplo com um seletor de nó
kubernetes.io/arch. - Para o PostgreSQL, o diretório de dados do banco de dados de reserva em um volume, montado sem
subPath. Os bancos de dados incluídos atendem a isso. - Para o PostgreSQL, um volume do banco de dados de reserva que não seja
ReadWriteOncePod. Cada atualização o monta a partir de um segundo pod no mesmo nó.
Se faltar algum desses itens, Contínuo (T2) fica acinzentado e o motivo aparece abaixo, por exemplo The Continuous tier can’t run on this pairing’s cluster yet: The DR cluster has no default StorageClass for the standby’s work volumes, ou The DR cluster’s agent is 0.0.1; a MariaDB standby on a cluster needs agent 0.0.2 or later.
O que acontece no cluster de recuperação para o PostgreSQL:
- Preparação. Na primeira vez, e sempre que a reserva precisa ser reconstruída a partir de outra base (por exemplo depois de um retorno ao primário ou de uma nova timeline), o agente para brevemente o banco de dados de reserva: o pod dele é reduzido a zero enquanto um pod de curta duração restaura o diretório de dados do banco de dados a partir da base física. O banco de dados então volta a iniciar como reserva ativa (hot standby) e reproduz o WAL enviado. O aplicativo da reserva fica em zero durante todo esse tempo, como sempre em uma reserva.
- Atualizações. Depois da preparação, cada atualização só traz para o banco de dados de reserva em execução o WAL enviado desde a anterior. Nada é reiniciado.
- Os testes até um momento específico rodam em um pod descartável,
scolah-drpitr-…, no namespace da reserva. Ele constrói sua própria cópia do banco de dados em um volume temporário, não escuta em nenhuma porta de rede e é excluído quando o teste termina. A reserva continua reproduzindo. - O failover traz primeiro o último envio, espera a reserva reproduzi-lo e depois promove o banco de dados e inicia o aplicativo.
Se uma preparação falhar depois de o diretório de dados do banco de dados de reserva ter sido esvaziado, ou se o agente parar no meio de uma (por exemplo porque o pod dele foi reiniciado), o banco de dados de reserva fica reduzido a zero, porque o diretório de dados dele está incompleto. Até ser preparado de novo:
- O failover e a promoção de emergência são recusados, com uma mensagem informando que o banco de dados de reserva está incompleto e precisa ser preparado de novo primeiro.
- A próxima atualização em Contínuo o prepara de novo a partir de uma base e, depois, inicia o banco de dados.
- Uma atualização em Intervalo o reconstrói: o agente apaga o banco de dados incompleto, deixa-o iniciar de novo como um banco novo e vazio e o preenche novamente a partir do backup em Intervalo mais recente. Durante esse curto período, a reserva não tem dados, e o failover continua recusado até o preenchimento terminar. O resultado da atualização lista os bancos de dados reconstruídos (
reinitialised=…).
O que acontece no cluster de recuperação para o MariaDB:
- O banco de dados de reserva continua rodando. Diferentemente do PostgreSQL, ele nunca é parado, nem mesmo na preparação: pods de curta duração carregam a base e reproduzem o binlog enviado pelo Service do banco de dados. Se uma reprodução falhar, a próxima atualização o prepara de novo a partir da base.
- Os testes até um momento específico rodam em um pod descartável
scolah-drpitr-…que constrói sua própria cópia do banco de dados, não escuta em nenhuma porta de rede e é excluído quando o teste termina. - O failover primeiro reproduz tudo até o último envio e depois inicia o aplicativo.
Limitações
Seção intitulada “Limitações”- O nível Contínuo é só para bancos de dados PostgreSQL e MariaDB, tanto em servidores Docker quanto em clusters Kubernetes. O MongoDB e os arquivos sempre mantêm o backup a cada 15 minutos.
- Os servidores Oracle MySQL não são compatíveis com o nível Contínuo; o MariaDB é.
- O nível Contínuo não está disponível com um banco de dados gerenciado por você no servidor de recuperação.
- O failover é em um só sentido até o retorno ao primário. Não há como desfazer depois que os domínios foram movidos.
- Sincronizado significa que os pontos de recuperação estão sendo enviados. Não prova que a reserva possa ser restaurada: confie em Última verificação e nos testes.
- Um aplicativo sem especificação de backup pode mostrar Sincronizado sem nada em seus pontos de recuperação.
- Só os bancos de dados PostgreSQL são restaurados em uma cópia temporária e verificados antes de substituírem os dados da reserva. Os outros bancos de dados são restaurados diretamente.
- A retenção é fixa: todos os backups por 48 horas e, depois, um por dia durante 30 dias, e em Contínuo as bases físicas e as alterações enviadas por 7 dias. Ela não é configurável por instalação, exceto que um período de Object Lock mais longo mantém os pontos de recuperação por mais tempo.
- Uma instalação que usa um banco de dados gerenciado por você (um serviço externo registrado) ainda não pode ser protegida. A pré-verificação a recusa, porque a reserva não teria nenhuma cópia desse banco de dados.