Saúde
Saúde reúne em uma única página o estado de tudo o que existe na sua organização. Administradores e membros podem abri-la. Clique em Atualizar para recarregar.
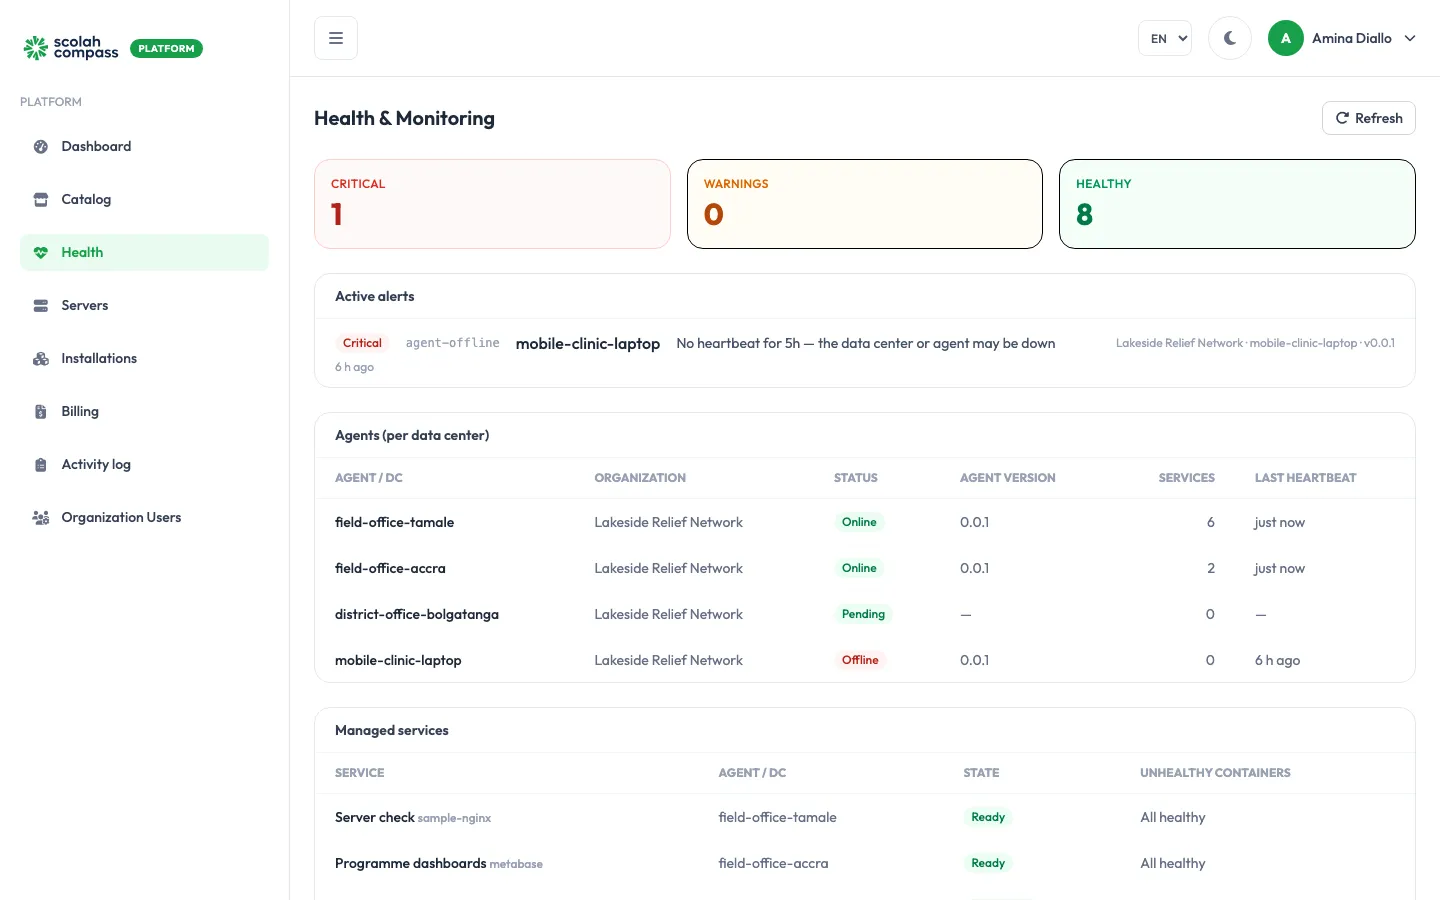
Os três blocos no topo contam os problemas por gravidade:
- Críticos: algo está fora do ar, como um servidor cujo agente parou de se comunicar.
- Avisos: algo está degradado, como uma instalação com um serviço que não está saudável.
- Saudáveis: todo o resto.
Alertas ativos
Seção intitulada “Alertas ativos”Cada alerta indica o que está errado, onde (organização, servidor e versão do agente) e há quanto tempo começou, por exemplo “No heartbeat for 1h — the data center or agent may be down”. Quando não há nada de errado, a página mostra Todos os sistemas saudáveis — sem alertas ativos.
Agentes
Seção intitulada “Agentes”Uma linha por servidor, com o estado da conexão, a versão do agente, o número de instalações e o último sinal:
| Estado | Significado |
|---|---|
| Online | Comunicando normalmente. |
| Atrasado | Perdeu comunicações recentes, mas ainda não é considerado offline. |
| Offline | Sem sinal há mais de 5 minutos. |
| Pendente | Cadastrado, mas nenhum agente se registrou ainda. |
| Bloqueado | Acesso cortado por um administrador. |
Serviços gerenciados
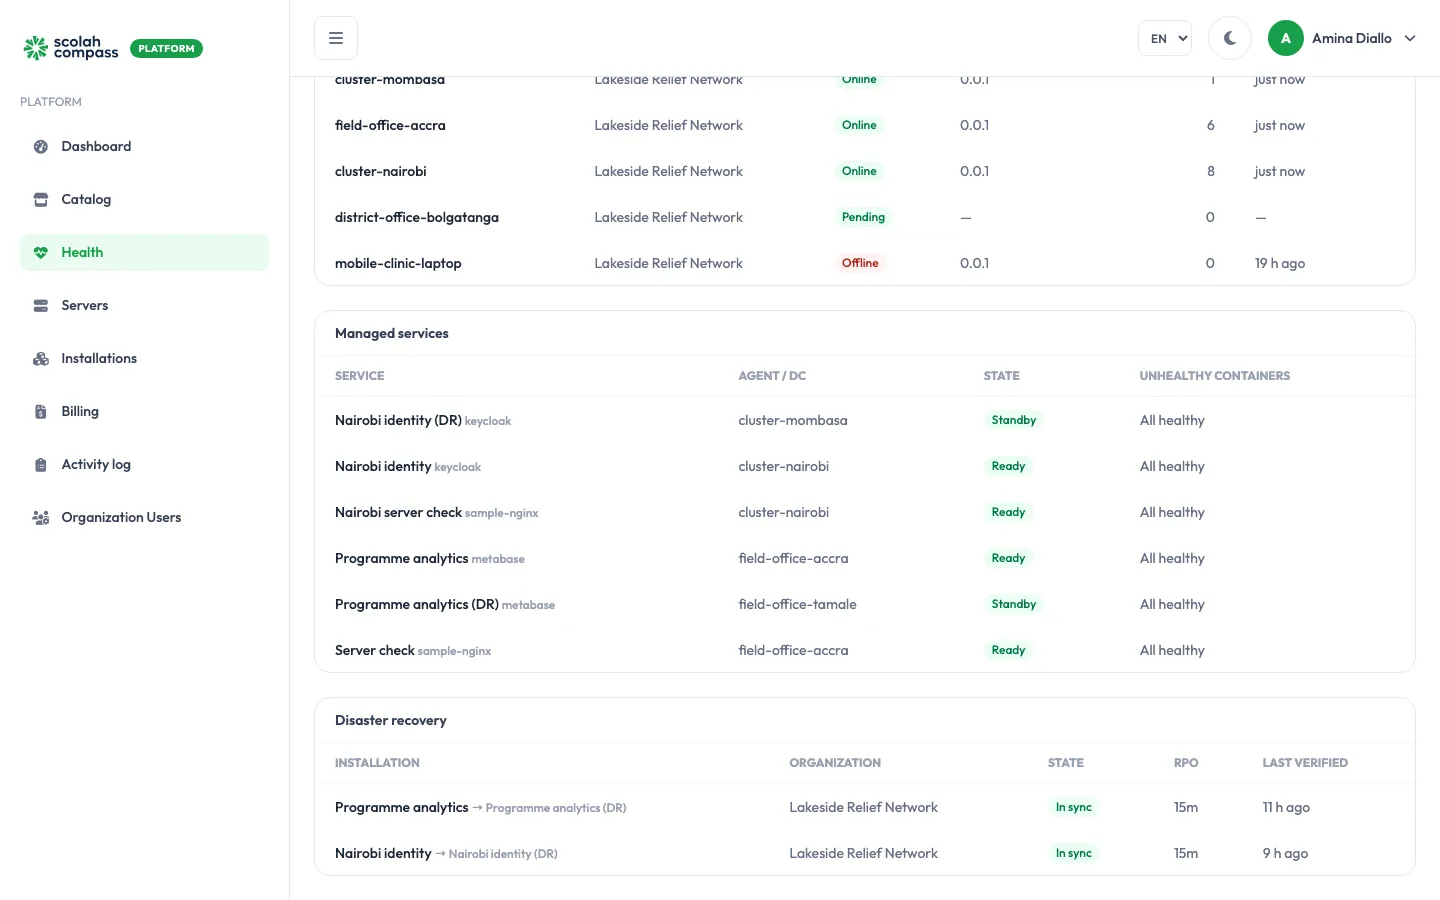
Seção intitulada “Serviços gerenciados”Cada instalação, seu servidor, seu estado e os eventuais Contêineres com falha. Tudo saudável significa que todos os serviços estão funcionando normalmente.
Conexões
Seção intitulada “Conexões”Cada conexão entre instalações, quando foi verificada pela última vez e quantas verificações seguidas falharam.
Recuperação de desastres
Seção intitulada “Recuperação de desastres”Esta seção só aparece quando pelo menos uma instalação tem a recuperação de desastres ativada. Ela tem uma linha por instalação protegida, com:
- Instalação: a instalação protegida, seguida de uma seta e da sua réplica de reserva, por exemplo Programme analytics → Programme analytics (RD)
- a organização
- o estado de DR, por exemplo Sincronizado
- o RPO: a idade do ponto de recuperação mais recente
- quando o ponto de recuperação mais recente passou pela Última verificação
Cada alerta de recuperação de desastres começa pelo nome da instalação, por exemplo “Programme analytics: DR recovery points are stale”.
Os bancos de dados de uma réplica de reserva informam starting uma vez, ao iniciar, e não são verificados de novo. Serviços gerenciados não conta isso como um problema, então uma réplica de reserva não é sinalizada enquanto inicializa. Um serviço de reserva realmente com problemas continua sendo sinalizado.
A recuperação de desastres gera estes alertas:
| Alerta | Gravidade | Gerado quando |
|---|---|---|
dr-not-protected |
Crítico | O pareamento está em Falhou: um failover não conseguiu colocar a réplica de reserva para funcionar. |
dr-stale |
Aviso | O pareamento está Desatualizado: uma verificação do ponto de recuperação mais recente falhou. |
dr-verify-stale |
Aviso | O pareamento está Sincronizado, mas nenhuma verificação teve sucesso nas últimas 48 horas (o dobro do intervalo da verificação diária), ou nunca. |
dr-rpo-breach |
Aviso | O ponto de recuperação mais recente tem mais que o dobro do intervalo de backup (30 minutos por padrão). No nível Contínuo, quando nada foi enviado nos últimos 10 minutos. |
dr-demoted |
Aviso | O nível Contínuo voltou para Intervalo, com o motivo. Permanece até um administrador escolher um nível. |
dr-slot-lag |
Aviso | Um slot de replicação do nível Contínuo retém metade ou mais do seu limite (10 GB por padrão) de WAL no servidor original. Somente PostgreSQL: o MariaDB não tem slot. |
dr-slot-at-risk |
Crítico | O estado de WAL de um slot de replicação do nível Contínuo é unreserved ou lost: o servidor original está excluindo WAL de que a réplica de reserva ainda precisa. No MariaDB, o servidor original excluiu um binlog antes que ele fosse enviado. |
dr-local-wal |
Aviso | O WAL aguardando envio está se acumulando no agente do servidor original acima do limite, porque o envio para o armazenamento de artefatos está falhando ou atrasando. |
dr-cleanup-pending |
Aviso | A limpeza do envio do nível Contínuo no servidor original falhou 3 vezes (o alerta indica o número de falhas e o último erro), ou a DR foi desativada há mais de 10 minutos e a limpeza está aguardando o agente do servidor original voltar a ficar online. A limpeza remove o slot de replicação e, em um cluster, a linha do pg_hba.conf e o pod de envio com o volume dele; ela é feita automaticamente assim que o agente voltar. Até lá, o slot retém WAL no servidor original, até o seu limite. O nível Contínuo não pode ser ativado para um novo pareamento de DR nesse servidor até a limpeza terminar. O alerta desaparece quando a limpeza é concluída com sucesso. |
O que fazer diante de um alerta
Seção intitulada “O que fazer diante de um alerta”- Agente offline ou atrasado: consulte O servidor ficou Offline.
- Serviços não saudáveis: abra a instalação e confira a aba Atividade. Consulte Uma instalação está com o estado Falhou ou Degradado.
- Alertas de recuperação de desastres: abra a aba Recuperação de desastres da instalação. Consulte Recuperação de desastres.