Santé
Santé regroupe sur une seule page l’état de tout ce qui se trouve dans votre organisation. Les administrateurs comme les membres peuvent l’ouvrir. Cliquez sur Actualiser pour recharger.
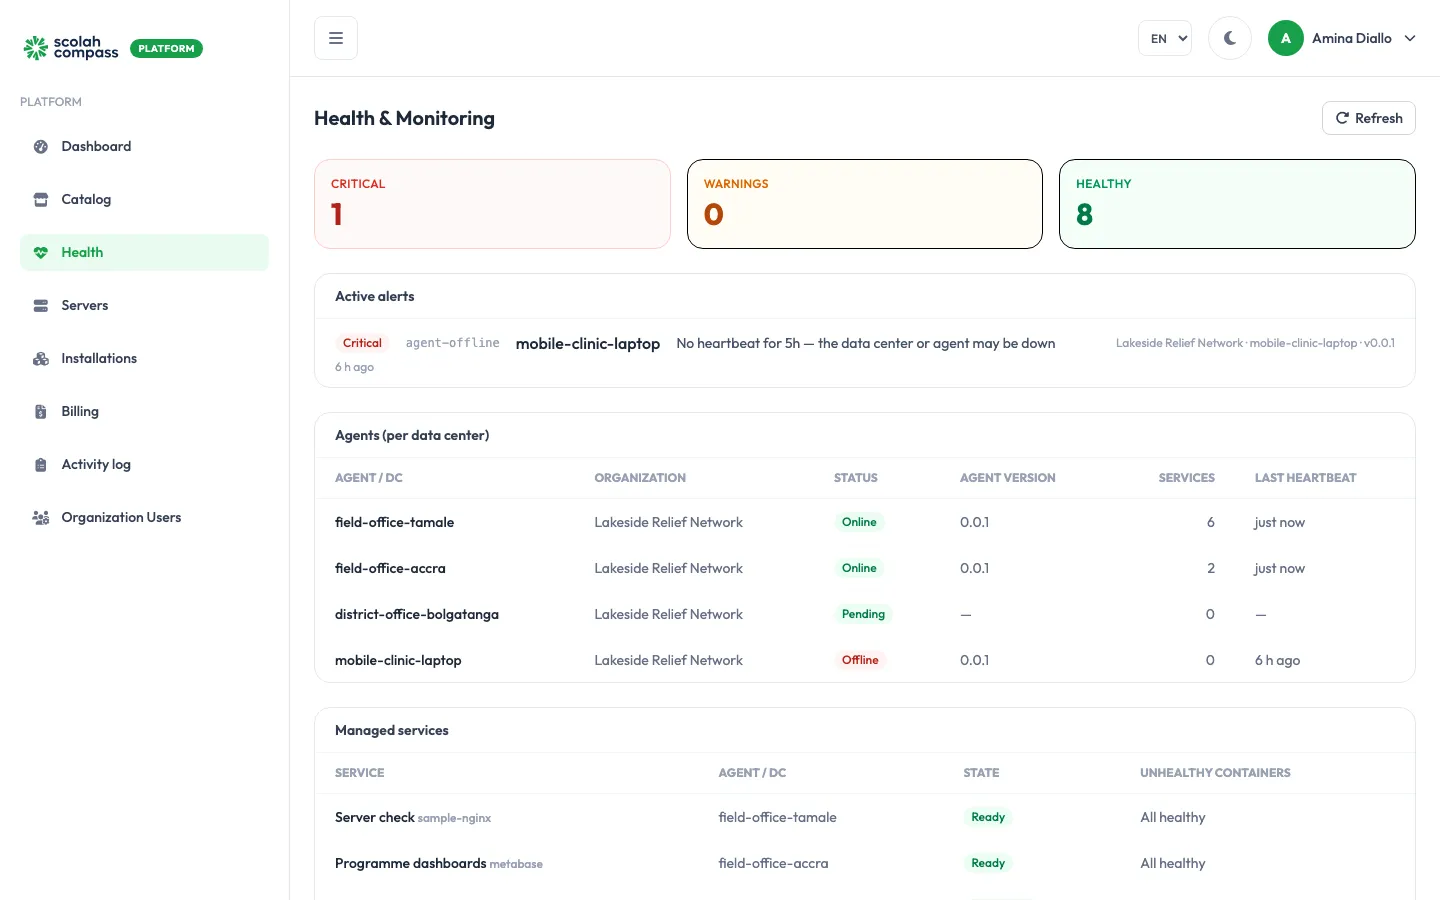
Les trois tuiles en haut comptent les problèmes par gravité :
- Critiques : quelque chose est hors service, comme un serveur dont l’agent a cessé de se manifester.
- Avertissements : quelque chose est dégradé, comme une installation avec un service défaillant.
- Sains : tout le reste.
Alertes actives
Section intitulée « Alertes actives »Chaque alerte indique ce qui ne va pas, où (organisation, serveur et version de l’agent), et depuis combien de temps, par exemple « No heartbeat for 1h — the data center or agent may be down » (aucun signal depuis 1 h — le centre de données ou l’agent est peut-être hors service). Lorsque rien ne va mal, la page affiche Tous les systèmes sont sains — aucune alerte active.
Une ligne par serveur, avec son état de connexion, la version de l’agent, le nombre d’installations et le dernier signal :
| État | Signification |
|---|---|
| En ligne | Se manifeste normalement. |
| En retard | A manqué des signaux récents, mais n’est pas encore considéré comme hors ligne. |
| Hors ligne | Aucun signal depuis plus de 5 minutes. |
| En attente | Enregistré, mais aucun agent ne s’est encore enrôlé. |
| Bloqué | Coupé par un administrateur. |
Services gérés
Section intitulée « Services gérés »Chaque installation, son serveur, son état et les éventuels Conteneurs défaillants. Tout sain signifie que chaque service fonctionne normalement.
Connexions
Section intitulée « Connexions »Chaque connexion entre installations, la date de sa dernière vérification, et le nombre de vérifications consécutives en échec.
Reprise après sinistre
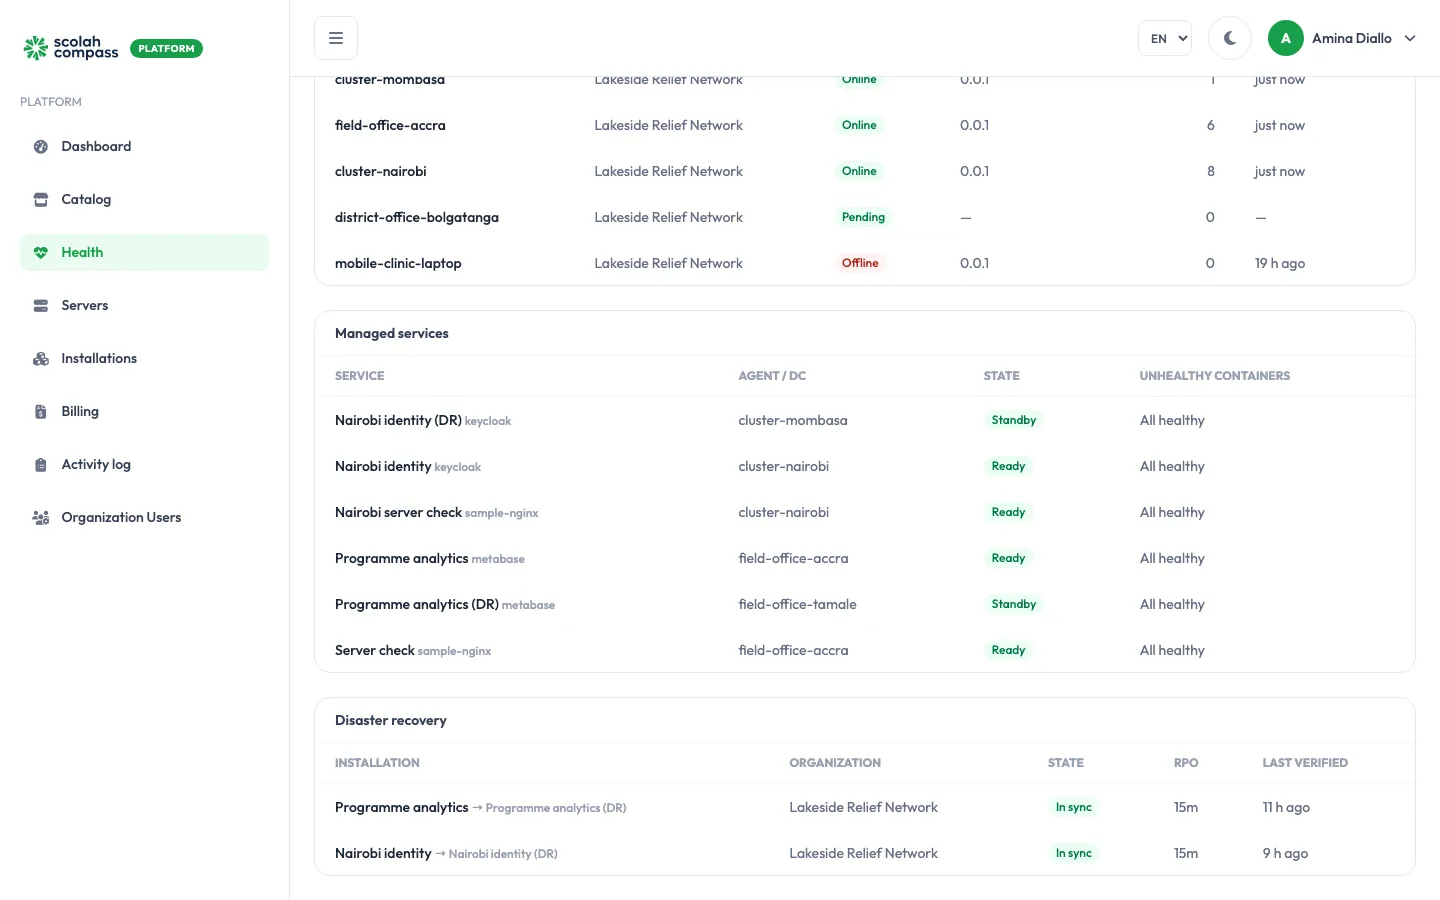
Section intitulée « Reprise après sinistre »Cette section n’apparaît que lorsqu’au moins une installation a la reprise après sinistre activée. Elle comporte une ligne par installation protégée, avec :
- Installation : l’installation protégée, puis une flèche et sa copie de secours, par exemple Analyses des programmes → Analyses des programmes (PRA)
- son organisation
- son état de reprise, par exemple Synchronisé
- son RPO : l’âge du point de restauration le plus récent
- la date de Dernière vérification de son dernier point de restauration
Chaque alerte de reprise après sinistre commence par le nom de l’installation, par exemple « Analyses des programmes: DR recovery points are stale ».
Les bases de données d’une copie de secours signalent starting une fois, au démarrage, et ne sont plus vérifiées ensuite. Services gérés ne compte pas cela comme un problème, donc une copie de secours n’est pas signalée pendant son démarrage. Un service de copie de secours réellement en mauvaise santé est toujours signalé.
La reprise après sinistre déclenche ces alertes :
| Alerte | Gravité | Déclenchée lorsque |
|---|---|---|
dr-not-protected |
Critique | L’appairage est en Échec : un basculement n’a pas pu démarrer la copie de secours. |
dr-stale |
Avertissement | L’appairage est Obsolète : une vérification du dernier point de restauration a échoué. |
dr-verify-stale |
Avertissement | L’appairage est Synchronisé, mais aucune vérification n’a réussi au cours des 48 dernières heures (deux fois l’intervalle de vérification quotidien), ou jamais. |
dr-rpo-breach |
Avertissement | Le point de restauration le plus récent date de plus de deux fois l’intervalle de sauvegarde (30 minutes par défaut). En Continu, lorsque rien n’a été envoyé depuis 10 minutes. |
dr-demoted |
Avertissement | Le niveau Continu est revenu en Intervalle, avec la raison. L’alerte reste jusqu’à ce qu’un administrateur choisisse un niveau. |
dr-slot-lag |
Avertissement | Un slot de réplication du niveau Continu conserve la moitié ou plus de sa limite (10 Go par défaut) de WAL sur le serveur d’origine. PostgreSQL uniquement : MariaDB n’a pas de slot. |
dr-slot-at-risk |
Critique | L’état WAL d’un slot de réplication du niveau Continu est unreserved ou lost : le serveur d’origine supprime du WAL dont la copie de secours a encore besoin. Sous MariaDB, le serveur d’origine a purgé un binlog avant son envoi. |
dr-local-wal |
Avertissement | Du WAL en attente d’envoi s’accumule sur l’agent du serveur d’origine au-delà de la limite, parce que l’envoi vers le magasin d’artefacts échoue ou prend du retard. |
dr-cleanup-pending |
Avertissement | Le nettoyage de l’envoi en Continu sur le serveur d’origine a échoué 3 fois (l’alerte donne le nombre d’échecs et la dernière erreur), ou la reprise a été désactivée il y a plus de 10 minutes et le nettoyage attend que l’agent du serveur d’origine revienne en ligne. Le nettoyage supprime le slot de réplication et, sur un cluster, la ligne de pg_hba.conf ainsi que le pod expéditeur et son volume ; il se fait automatiquement dès que l’agent est de retour. En attendant, le slot conserve le WAL sur le serveur d’origine, jusqu’à sa limite. Le niveau Continu ne peut pas être activé pour une nouvelle reprise sur ce serveur avant la fin du nettoyage. L’alerte disparaît dès que le nettoyage réussit. |
Que faire en cas d’alerte
Section intitulée « Que faire en cas d’alerte »- Agent hors ligne ou en retard : voir Le serveur est passé Hors ligne.
- Services défaillants : ouvrez l’installation et consultez son onglet Activité. Voir Une installation est en Échec ou Dégradée.
- Alertes de reprise après sinistre : ouvrez l’onglet Reprise après sinistre de l’installation. Voir Reprise après sinistre.